Qwen3.8-27B は、RX 9070 XT 16GB では 8.8〜12.2 tok/s しか出ない。同じ日に同じ環境で測った GLM-4.7-Flash は 29.0〜41.2 tok/s で、しかもファイルサイズは GLM のほうが2GB大きい。
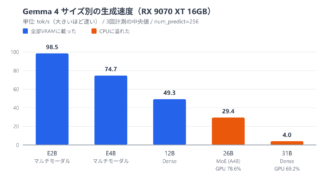
「16GBに収まるかどうか」でモデルを選ぶと、この結果は説明できない。実際に効いているのはdense か MoE かである。Gemma 4 の5サイズを測ったときにも同じことが起きていて、あれが偶然ではなかったと確かめられた。
この記事は、2026年8月に公開された Qwen3.8-27B を軸に、16GB で実際に何が動くのかを実測値だけで書く。
【結論】16GBで選ぶなら MoE。Qwen3.8-27B は「載るが遅い」
計測はすべて同じ環境(RX 9070 XT・Ollama 0.34.4・コンテキスト4K・2026年9月29日)で、生成速度は4回測って初回を捨てた中央値である。以下は ROCm ランタイムの値で、Vulkan の値は後の章に出す。
| モデル | 構成 | ファイルサイズ | GPUに載った割合 | 生成 tok/s | 読込 tok/s |
|---|---|---|---|---|---|
| Qwen3-Coder-30B-A3B | 30B MoE(A3B) | 19.20 GB | 82% | 38.3 | 1,000 |
| Gemma 4 26B | 26B MoE(アクティブ3.8B) | 18.41 GB | 78% | 31.8 | 856 |
| GLM-4.7-Flash | 30B MoE(アクティブ3.8B) | 19.46 GB | 81% | 29.0 | 575 |
| Qwen3.8-27B | 27B dense | 17.45 GB | 84% | 8.8 | 343 |
| Qwen3.8-27B(MTP版) | 同上+MTP | 18.10 GB | 76% | 10.9 | 296 |
| Qwen3.6-27B(前世代) | 27B dense | 17.14 GB | 86% | 9.1 | 362 |
| Qwen3.8-27B Q8_0 | 27B dense | 29.60 GB | 49% | 3.1 | 149 |
用途で選ぶならこうなる。
| やりたいこと | 選ぶもの | 理由 |
|---|---|---|
| 速度を優先 | Qwen3-Coder-30B-A3B | 38 tok/s。読込も 1,000 tok/s で最速 |
| 画像も読ませたい | Gemma 4 26B | 32 tok/s。vision 対応 |
| 長い文章を読ませる | GLM-4.7-Flash(ROCm で) | 29 tok/s。読込は ROCm のほうが1.7倍速い。ただし日本語の質には不満の声が多い |
| Qwen系がどうしても要る | MTP版を選ぶ | 通常版より2割速い。出力は1文字も変わらない |
| — | Q8_0 は選ばない | 3.1 tok/s。300字書くのに2分近くかかる |
【本題】サイズが大きいほうが速い。dense と MoE で3.3倍
一番おかしく見えるのがここだ。GLM-4.7-Flash(19.46GB)は Qwen3.8-27B(17.45GB)より2GB大きいのに、3.3倍速い。
| GLM-4.7-Flash | Qwen3.8-27B | |
|---|---|---|
| 総パラメータ | 30B | 27.8B |
| 1トークンごとに使う量 | 3.8B(MoE) | 27.8B 全部(dense) |
| ファイルサイズ | 19.46 GB | 17.45 GB |
| GPUに載った割合 | 81% | 84% |
| 生成速度 | 29.0 tok/s | 8.8 tok/s |
16GBに対してどちらも溢れていて、溢れ方(GPU 81%と84%)はむしろ Qwen のほうがマシである。それでも3倍以上の差が付く理由は、CPU側に置かれた重みを何回読みに行くかにある。
MoE は毎トークンで一部の専門家(エキスパート)しか使わないので、CPU側へのアクセス回数がそもそも少ない。dense は毎トークンで全パラメータを使うため、あぶれた分に毎回PCIe越しでアクセスする。この往復がボトルネックになる。
今回は MoE を3つ測ったが、Qwen3.8-27B に対する倍率は 3.3倍(GLM)・3.6倍(Gemma 4)・4.4倍(Qwen3-Coder)と、どれも同じ方向に出た。Gemma 4 の記事では 26B(MoE) と 31B(dense) で7.4倍の差が出ている。メーカーも世代も違う組み合わせで同じことが起きたので、モデル固有の癖ではなく、16GBで溢れたときの一般則だと考えていい。
つまり、VRAMに収まらないモデルを選ぶときは、パラメータ数でもファイルサイズでもなく「MoEかどうか」を見る。
追試: 半分をCPUに置いても、MoEなら48 tok/s 出た
9月30日に、NVIDIA の Nemotron 3.5 Lightning(30B-A3B) でも確かめた。総パラメータ30B、1トークンで使うのは3B の MoE である。この3本は同じ晩に続けて測った(日をまたぐと数字が動くため。後述)。
| モデル | ファイルサイズ | GPUに載った割合 | 生成 tok/s(ROCm) |
|---|---|---|---|
| Nemotron 3.5 Lightning | 25.63 GB | 54% | 48 |
| Qwen3-Coder-30B-A3B | 19.20 GB | 82% | 49 |
| GLM-4.7-Flash | 19.46 GB | 81% | 38 |
Nemotron は46%をCPU側に置いている。16GBに対して9GB以上あぶれている計算で、この記事で一番ひどい溢れ方である。それでも48 tok/s 出る。
一方 Qwen3.8-27B は、84%をGPUに載せて 8.8 tok/s だった。溢れ方が倍ひどいのに、5倍以上速い。dense か MoE かの差は、GPUに何%載ったかを完全に上書きする。
これで Alibaba・Google・Zhipu・NVIDIA の4社で同じ結果になった。16GBで溢れたときに効くのは、MoEかどうかだけである。
ただし、選ぶ理由にはならない。同じ晩の Qwen3-Coder が 6GB 小さくて同じ速さである。Nemotron の売りは100万トークンのコンテキストだが、16GBで長い文脈を持たせる余裕は無い。

 ポチップ
【MTP】タグを変えるだけで2割速くなる。出力は同じ
Qwen3.8 には 27b-mtp-q4_K_M というタグがある。MTP(Multi-Token Prediction)は次の1トークンだけでなく数トークン先まで予測する仕組みで、Qwen3.8-27B にはその専用ヘッドが入っている。
| モデル | 生成 tok/s |
|---|---|
| qwen3.8:27b-q4_K_M | 8.8(ROCm)/ 12.2(Vulkan) |
| qwen3.8:27b-mtp-q4_K_M | 10.9(ROCm)/ 14.1(Vulkan) |
ROCm で24%、Vulkan で16%速い。しかも同じ質問・同じシード(temperature 0)で出力を比べたところ、要約もコードも1文字も違わなかった。速度だけが変わる。
Qwen3.8 を16GBで使うなら MTP 版を選ばない理由がない。ただし、それでも 10.9 tok/s である。MoE 勢の 30〜38 tok/s には遠い。
なお、9月22日に同じ計測をしたときは MTP の効きが4割だった。この差も、次の章の「測り直すと変わる」に含まれる。
【注意】同じ設定でも、測り直すと数字が変わる
この記事でいちばん伝えたいのは、実はここかもしれない。
Ollama を 0.34.2 から 0.34.4 に上げただけで、速度が大きく動いた。
| モデル(ROCm) | 0.34.2(9月22日) | 0.34.4(9月29日) |
|---|---|---|
| GLM-4.7-Flash | 35.3 | 29.0 |
| Qwen3.8-27B | 6.8 | 8.8 |
| Gemma 4 26B | 30.0 | 31.8 |
さらに悪いことに、版を固定しても数字は動く。確かめるために、2週間前に使った古い版(0.30.10)を、同じ日にもう一度動かしてみた。モデルのファイルも起動時の引数も、GPUへの載せ方も同一である。
| モデル | 9月14日の 0.30.10 | 9月29日の 0.30.10 |
|---|---|---|
| qwen3:14b(Vulkan) | 19.1 | 61.7 |
| gpt-oss:20b(Vulkan) | 37.8 | 121.9 |
| gpt-oss:20b(ROCm) | 51.9 | 108.0 |
同じソフト・同じモデルで、2週間後に3倍になった。間に挟まっているのは Windows Update と再起動だけで、原因は特定できていない。
もう一つ。一部をCPUに逃がしているモデルは、測り直すたびに1〜3割動く。Gemma 4 26B は同じ版・同じ晩に2回測って、ROCm 31.8 と 41.3、Vulkan 54.7 と 45.9 だった。1回の中の4試行は 31.8 / 31.8 / 31.9 / 31.8 と揃っているので、ぶれているのは測り直すたびである。全部GPUに載るモデル(gpt-oss・qwen3:14b)は2〜3%しか動かない。
翌日にも同じことが起きた。GLM-4.7-Flash は 9月29日に 29.0 tok/s、9月30日に 37〜39 tok/s。版(0.34.4)も設定も同じで、丸一日で3割上がっている。先ほどの追試で Nemotron と並べた 38 tok/s は、この日の数字である。だから追試の3本は、同じ晩の中で比べた。
だから、よそのベンチ記事の tok/s を自分の環境の予測に使わないほうがいい。この記事の数字も、計測日と版を書いてあるのはそのためだ。倍率(MoEはdenseの3〜4倍)のような比は測り直しても向きが変わらないが、絶対値は動く。
設定を比べるときは、同じ晩の中で続けて測って、それを2周する。別の日の数字を並べると、ぶれを効果と取り違える。この記事のコンテキスト長の章は、それで一度間違えた(後述)。
【Q8_0】量子化を上げると崖から落ちる
参考として Q8_0(29.6GB)も測った。
- GPUに載ったのは49%。半分がCPU側
- 生成3.1 tok/s、読込 149 tok/s
- モデルの初回ロードに67秒
300字の返事に2分近くかかる計算で、対話には使えない。Gemma 4 の31Bで見た崖と同じ現象である。16GBでは Q4_K_M が上限、と考えておけばいい。
【コンテキスト長】4Kから32Kにしても、ほぼ変わらない
以前、コンテキスト長を4Kから32Kにしても生成速度は変わらないと書いた。あのとき測ったモデルは、どれも16GBに全部載っていた。溢れているモデルでも同じことが言えるのかを確かめた。
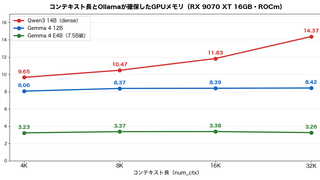
最初に測ったときは、Qwen3.8-27B が4Kの 8.8 tok/s から32Kで 7.4 tok/s に落ち、「溢れていると遅くなる」ように見えた。ところがこの3つは別々の回に測っていた。前の章のとおり、溢れているモデルは測り直すたびに1〜3割動く。これでは差が本物か分からない。
そこで同じ晩に4K・16K・32Kを続けて測り、それを2周した(9月30日・0.34.4)。数字は1周目 / 2周目である。
Qwen3.8-27B(dense・16GBに収まらない)
| コンテキスト | 生成 tok/s(ROCm) | 生成 tok/s(Vulkan) | GPUに載った割合 |
|---|---|---|---|
| 4,096 | 7.2 / 7.7 | 9.6 / 10.0 | 84% / 80% |
| 16,384 | 7.9 / 7.9 | 9.2 / 9.3 | 80% / 77% |
| 32,768 | 7.8 / 7.9 | 9.4 / 9.4 | 76% / 72% |
GLM-4.7-Flash(MoE・16GBに収まらない)
| コンテキスト | 生成 tok/s(ROCm) | 生成 tok/s(Vulkan) | GPUに載った割合 |
|---|---|---|---|
| 4,096 | 27.5 / 27.5 | 31.9 / 33.7 | 81% / 77% |
| 16,384 | 26.6 / 27.2 | 30.7 / 31.8 | 78% / 75% |
| 32,768 | 26.9 / 27.7 | 29.4 / 30.1 | 75% / 72% |
ほとんど変わらない。GPUに載る割合は4Kから32Kで8ポイント下がっているのに、生成速度は2周とも同じ幅に収まっている。はっきり下がったのは GLM を Vulkan で動かしたときだけで、それも約1割である。
つまり、前の記事の「変わらない」は、溢れているモデルでもだいたい正しかった。最初に見えた16%の低下は、コンテキストのせいではなく測り直しのぶれだった。
ここから言えることは二つある。
- 長い文脈が要るなら、速度を気にせずコンテキストを伸ばしていい
- 設定の違いを比べるときは、同じ回の中で比べる。日を跨いだ数字を並べると、ぶれを効果と取り違える
溢れた分はメインメモリに置かれる。MoE を16GBで動かすなら、メインメモリの側にも余裕が要る。
 ポチップ
【ROCm vs Vulkan】生成はVulkan、読込はモデルによる
9月中旬にVulkanとROCmを比較したとき、Qwen3.6-27B では Vulkan が11%遅かった。0.34.4 で測り直すと、生成はすべて Vulkan が速い。
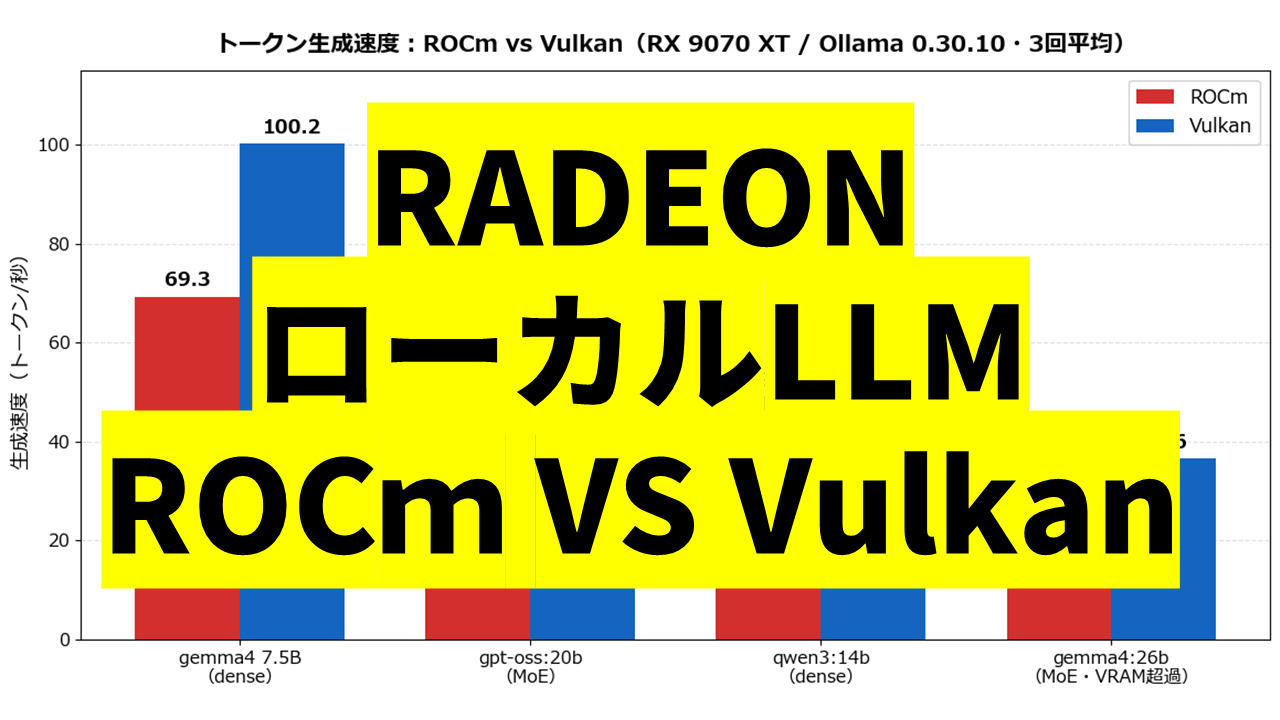
| モデル | 生成 ROCm | 生成 Vulkan | 読込 ROCm | 読込 Vulkan |
|---|---|---|---|---|
| Qwen3-Coder-30B-A3B | 38.3 | 51.8 | 1,000 | 1,068 |
| Gemma 4 26B | 31.8 | 54.7 | 856 | 243 |
| GLM-4.7-Flash | 29.0 | 41.2 | 575 | 約330(1回だけ18) |
| Qwen3.8-27B | 8.8 | 12.2 | 343 | 554 |
生成は4モデルとも Vulkan が速く、これはコンテキスト長の2周でも同じ向きに出た。読込はモデルによって逆になる。Gemma 4 と GLM は ROCm のほうが速い。
GLM-4.7-Flash を Vulkan で動かしたとき、一度だけ読込が 18 tok/s まで落ちた。約2,500トークンの文章を読ませるのに140秒かかる速さで、その回の4試行は 18.1 / 17.9 / 18.3 / 18.5 と揃っていた。ところが同じ版・同じ4Kで別の晩に2回測り直すと、337 と 338 に戻った。コンテキスト16K・32Kや前の版(0.34.2)も含めると、Vulkan で GLM に読ませたのは10回で、18 まで落ちたのはこの1回だけ(他は 321〜338)。その回は、直前に他のモデルを7つ続けて動かした後だった。関係があるかは分からない。
長い文章を読ませるなら GLM は ROCm で動かす(575 tok/s と約330 tok/s)。短い指示から長く書かせるだけなら Vulkan でいい。こういう当たり外れがあるので、自分が使うモデルで両方試すしかない。
【出力の質】速さでは選べない。全モデルが同じ問題で間違えた
速度だけ見ても仕方がないので、同じ4問を出して中身を読んだ(temperature 0・シード固定)。
指示追従はどれも不完全だった。「3行・各40字以内・体言止め」は Gemma 4 だけが字数を超え、「200字ちょうど・だ・である調」はどのモデルも字数を守れない。GLM は指定したのに「ですます調」と Markdown の太字が混ざった。
Pythonのコードは4モデルとも動くものを書いた。ただし「表示する関数」と指示したのに、4モデルとも値を返すだけで表示しなかった。実装として一番丁寧だったのは Gemma 4 26B で、例外処理まで入れてきた。
そして一番大事な結果がこれだ。次の文の誤りを指摘させたら、あとから測った gpt-oss:20b・Qwen3-Coder・qwen3:14b も含めて、7モデル全部が「誤りなし」と答えた。
バイクの任意保険は排気量が大きいほど保険料が上がるため、250ccから400ccに乗り換えると保険料も上がる。
これは誤りである。筆者が実際にダイレクト3社で見積もったところ、250ccと400ccで保険料は1円も変わらなかった。バイクの任意保険は125cc超なら同じ区分だからだ。
世間で広く信じられている間違いは、ローカルLLMでは検出できない。速いモデルでも遅いモデルでも同じように間違えた。事実確認の道具として使ってはいけない、というのが実測から言えることである。
【計測環境と方法】
| 項目 | 内容 |
|---|---|
| GPU | AMD Radeon RX 9070 XT(VRAM 16GB・gfx1201) |
| ドライバ | 32.0.31035.1003(2026年7月24日) |
| 推論 | Ollama 0.34.4(同梱の ROCm 7.1 ランタイム/Vulkan) |
| 計測日 | 2026年9月29日(版の比較のみ9月14日の記録と対比。コンテキスト長と Nemotron の追試は9月30日に同じ晩で2周) |
| 量子化 | Q4_K_M(Q8_0 のみ参考計測) |
| KVキャッシュ | f16・Flash Attention 有効 |
| 測り方 | 生成300トークン×4回・初回を捨てた中央値。読込は約2,500トークンの長文×4回 |
| VRAM | Windows のパフォーマンスカウンタを約2秒間隔でポーリングした区間ピーク |
ここで言う ROCm は Ollama に同梱されているランタイムのことで、別途インストールする ROCm とは別物である。どのROCmを入れるべきかは別記事にまとめてある。
【この計測の限界】
- 1台のマシンでの結果である。CPU・メモリ帯域・PCIe世代が違えば、溢れたときの速度は変わる
- 絶対値は測り直すと動く(前述)。比較に使えるのは倍率のほうである。同じ晩に2周したのはコンテキスト長の比較だけで、他の表は1回の計測である
- 出力の質は4問しか見ていない。ベンチマークスコアではなく、傾向をつかむためのもの
- Qwen3.8 には大型版もあるが、16GBで動く見込みが無いので測っていない
- Kimi K3・GLM-5 は Ollama にクラウド用のタグしか無く、ローカルでは動かせない(2026年9月時点)
【まとめ】
- 16GBで溢れるモデルを選ぶなら、MoEかどうかだけ見ればいい。denseとの差は3〜4倍。46%をCPUに置いた MoE(Nemotron)が48 tok/s、84%をGPUに載せた dense(Qwen3.8)が8.8 tok/s
- 速さなら Qwen3-Coder-30B-A3B(38 tok/s)。画像を読ませたいなら Gemma 4 26B、長文を読ませるなら GLM-4.7-Flash を ROCm で
- Qwen3.8-27B は dense なので16GBでは遅い。使うなら MTP 版(2割速い・出力は同じ)
- Q8_0 は崖。3.1 tok/s で対話にならない
- コンテキストを4Kから32Kに伸ばしても、生成速度はほぼ変わらない。溢れているモデルでも同じ(GLM の Vulkan だけ約1割減)
- 速度の絶対値は、版でも日でも動く。同じ 0.30.10 が2週間後に3倍になった
- どのモデルも、世間に流通している誤りは指摘できない
それでも「dense の 27B を快適に動かしたい」「Q8 で精度を落としたくない」なら、答えは量子化ではなく VRAM の容量になる。16GB のまま工夫するより、VRAM の多い GPU を載せた構成を見積もったほうが早い。
もう一つの道は、GPU を足すのではなく、メインメモリを GPU と共有するミニPCにすることだ。Ryzen AI Max+ 395 を積んだ GMKtec の EVO-X2 は、64GB と128GB の構成がある。2026年10月1日時点の公式セール価格は、64GB版で34万7,999円からだった。
ただし筆者は持っていないので、速度は測っていない。メモリの帯域は RX 9070 XT の半分以下なので、dense の27Bが速くなるとは限らない。向いているのは、16GBに収まらない大きな MoE を丸ごと載せる使い方だ。
次は、このモデルたちをエージェントとして使えるかを試す。ツールを呼んで、結果を読んで、次の手を決める、という使い方が16GBで成立するのかは、速度とはまた別の話になる。
ローカルLLMをRadeonで始めるところからの手順は、完全ガイドにまとめてある。
参考文献
- Qwen/Qwen3.8-27B|Hugging Face ― 27B dense・262,144トークン・MTP・Apache 2.0
- qwen3.8|Ollama ― タグ一覧・thinking が既定で有効
- glm-4.7-flash|Ollama ― 30B-A3B MoE(アクティブ3.8B)・198Kコンテキスト
- qwen3-coder|Ollama ― 30B-A3B MoE
- Gemma 4 model card|Google
コメント