前回の記事では、RX 9070 XTでローカルLLMが「普通に戦える」ことを確認した。
その際バックエンドの話は「とりあえずVulkanでOK」で済ませたが、今回はその宿題を回収する。VulkanとROCm、結局どっちが速いのか。 同じマシン・同じモデル・同じ日に、条件を揃えて実測した。
先に断っておくと、結果は「どちらかが常に勝つ」という単純なものにはならなかった。だが、だからこそ面白い。自分の使い方ならどちらを選ぶべきかが、この記事を読めば判断できるはずだ。
【2026年9月追記】ドライバ更新後に測り直したら、結論が逆転した
この記事の数字は 2026年7月・AMD Software 26.1.1・Ollama 0.30.10 のものである。9月に同じマシン(ドライバは 32.0.31035.1003 に更新済み)で、同じ4モデル+4モデルを同じプロンプトで測り直したところ、7月の「生成は Vulkan 優勢」が崩れた。
| モデル(f16・FA オン) | 生成 ROCm | 生成 Vulkan | 読込 ROCm | 読込 Vulkan | 7月の生成(ROCm / Vulkan) |
|---|---|---|---|---|---|
| gemma4(E4B・7.5B級) | 99.6 | 133.0 | 4,815 | 3,160 | 69.3 / 100.2 |
| gpt-oss:20b(MoE) | 54.0 | 37.5 | 2,469 | 2,527 | 74.4 / 64.8 |
| qwen3:14b(dense) | 53.1 | 19.2 | 1,979 | 365 | 49.1 / 60.6 |
| gemma4:26b(MoE・VRAM超過) | 33.4 | 36.3 | 867 | 950 | 28.0 / 36.6 |
| gemma4:e2b | 145.0 | 195.7 | 8,150 | 4,480 | — |
| gemma4:12b(dense) | 60.5 | 29.4 | 1,908 | 575 | — |
| gemma4:31b(dense・超過) | 4.7 | 4.3 | 222 | 103 | — |
単位は tok/s。4回計測の初回を除いた中央値。7月は3回平均で、絶対値は日によって1〜2割動く(7月の記事にも書いたとおり)ので、7月との比較は傾向だけを見てほしい。
何が変わったか。
- dense の 12B〜14B で Vulkan が大きく落ちた。 qwen3:14b は 7月 60.6 → 19.2 tok/s。同じモデルで ROCm は 53.1。7月に「Vulkan +23%」だった組み合わせが、今は ROCm が 2.8倍速い
- ROCm の読込(プロンプト処理)が全モデルで伸びた。 gemma4 E4B は 2,797 → 4,815、gpt-oss:20b は 1,316 → 2,469
- Vulkan が生成でまだ勝つのは、4B以下の小さい dense と MoE の 26B だけ。 それも読込は ROCm が上
- gpt-oss:20b は両方とも7月より遅い(ROCm 74.4 → 54.0)。think の指定・seed の有無を7月と揃えて測り直しても同じだったので、計測条件の差ではない
原因はどれか。 7月から変わったのは Ollama(0.30.10 → 0.34.0)と AMD ドライバ(26.1.1 → 32.0.31035.1003)の2つで、KV キャッシュ・Flash Attention・コンテキスト長・モデルファイルは同じである。そこで 7月と同じ Ollama 0.30.10 を zip で展開して今のドライバで動かしたところ、Vulkan の qwen3:14b は 19.1 tok/s と、0.34 と同じ崩れ方をした。LM Studio でも7月と同じランタイム(llama.cpp 2.23.1)で 12B の Vulkan が ROCm の半分だった。Ollama やランタイムの版を戻しても直らないので、原因はドライバ側である。ドライバをロールバックして確認まではしていないが、他に変わったものが無い。
いま選ぶなら。 迷ったら ROCm。生成も読込も、12B 以上の dense では ROCm が圧倒的で、MoE でも読込は ROCm が上。Vulkan を選ぶ理由が残るのは「4B以下の小さいモデルで短い会話だけ」のときに限られる。7月の「チャット中心なら Vulkan」は、いまのドライバでは通用しない。 逆に言えば、ドライバが直れば戻る可能性があるので、次の大きなドライバ更新でまた測る。
なお KV キャッシュを q8_0 にした日常設定でも順位は同じだった(差は ±10% 以内)。LM Studio でも同じ3モデルを測り、勝敗は Ollama と全モデル一致した(E4B は Vulkan、12B dense は ROCm が2倍、26B MoE は ROCm やや上)。
以下は 7月時点の記事をそのまま残す。数字は当時のものとして読んでほしい。測り方と落とし穴は今も有効である。
【結論】用途とモデルで勝者が入れ替わる
いきなり結論の表から。
| 観点 | 勝者 | 例外 |
|---|---|---|
| トークン生成速度(チャットの体感) | Vulkan(+23〜45%) | gpt-oss:20bだけはROCmが+15% |
| プロンプト処理速度(長文読み込み) | ROCm(+16〜76%) | gpt-oss:20bだけはVulkanが2.2倍 |
| VRAM超過時(CPUに溢れる大型モデル) | 生成はVulkan、読み込みはROCm | どちらも一長一短 |
【2026年9月追記】この表は AMD Software 26.1.1 時点の結果である。ドライバ更新後は生成も ROCm 優勢に変わった(冒頭の追記を参照)。
つまり、チャットや文章生成が中心ならVulkan、RAGや長文要約など「読ませる」用途が多いならROCmという使い分けが基本線になる。ただしgpt-oss:20bのように傾向が真逆になるモデルもあるため、常用モデルが決まっているなら自分で測るのが最終回答だ(測り方も本記事で解説する)。
なおこの傾向はOllamaでもLM Studioでも同じだった(後半で検証する)。どちらも中身は同じllama.cppなので、バックエンド選びの結論はツールをまたいで使い回せる。
【前提】計測環境と条件
環境は前回と同じ。
| 項目 | スペック/バージョン |
|---|---|
| GPU | Radeon RX 9070 XT 16GB |
| CPU | Ryzen 9 7900X |
| RAM | DDR5 64GB |
| OS | Windows 11 25H2 |
| AMD Software | 26.1.1 |
| Ollama | 0.30.10 |
| LM Studio | llama.cpp ランタイム 2.23.1(Vulkan / ROCm とも) |
計測条件は次のとおり。すべて同じ日・同じマシン・モデル単独ロードで、バックエンドだけを切り替えて測っている。

 ポチップ
 ポチップ
- 生成速度(tg): 同一プロンプトで300トークン生成 × 3回の平均。temperature 0
- プロンプト処理速度(pp): 約2,000トークンの長文を読み込ませ、処理速度を3回計測。プロンプト先頭を毎回変えてキャッシュを無効化
- Flash Attention有効。ロードのたびに空きVRAM(15.3GiB)を確認
- どのバックエンドで動いているかは、サーバーログの
inference compute行(library=ROCm/library=Vulkan)で毎回確認
ばらつきはどの計測も±1%程度で、再現性は良好だった。なお絶対値は日やマシンの状態で1〜2割変動することを先に断っておく(実際、前回記事のgemma4は約91 tok/s、今回は約69 tok/sと差が出ている)。本記事の主眼はあくまで「同一条件でのバックエンド間の比較」だ。
なお、PCを買い替えるならサイコムがおすすめだ。
【本題1】トークン生成速度:基本はVulkan優勢
まず、チャットの体感を支配する生成速度から。
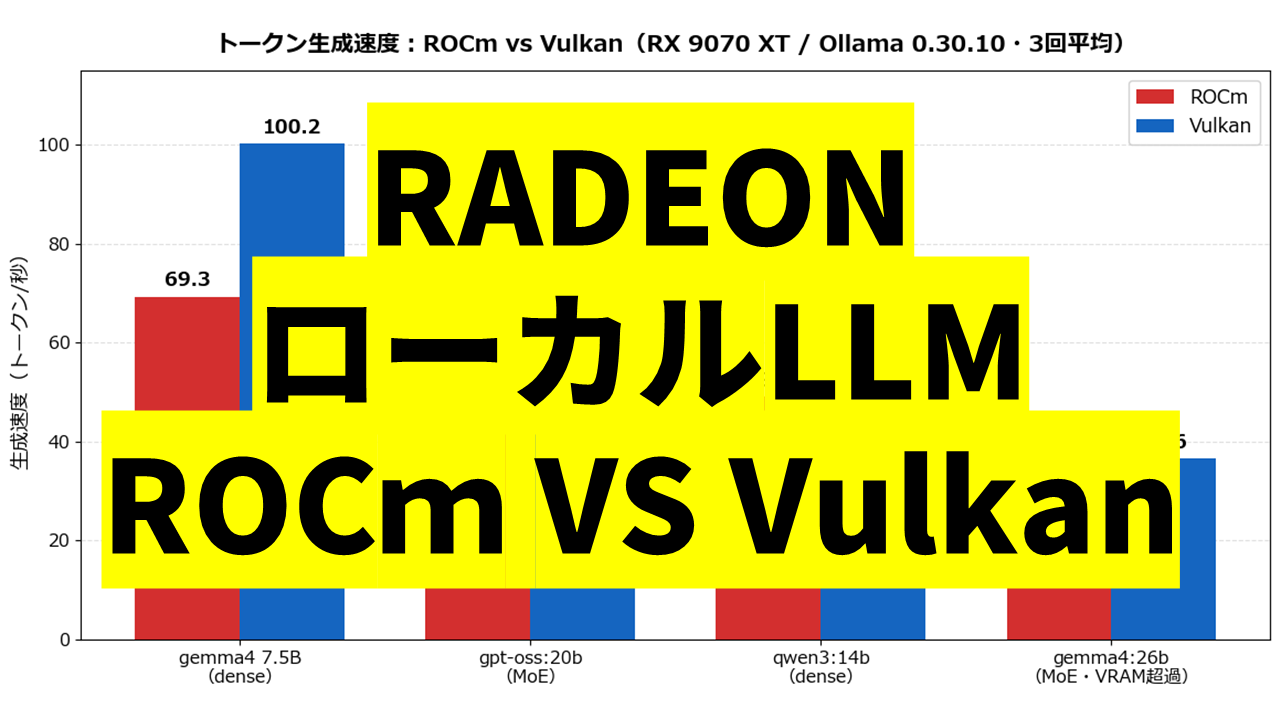
| モデル | 種別 | ROCm | Vulkan | 差 |
|---|---|---|---|---|
| gemma4(7.5B級) | dense | 69.3 tok/s | 100.2 tok/s | Vulkan +45% |
| gpt-oss:20b | MoE | 74.4 tok/s | 64.8 tok/s | ROCm +15% |
| qwen3:14b | dense | 49.1 tok/s | 60.6 tok/s | Vulkan +23% |
| gemma4:26b(VRAM超過) | MoE | 28.0 tok/s | 36.6 tok/s | Vulkan +31% |

4モデル中3つでVulkanの勝ち、それも1〜4割という無視できない差だ。gemma4 7.5Bに至ってはVulkanで100 tok/s超えを記録した。「Vulkan=互換性重視の遅い方」というかつての常識は、少なくともRDNA4では完全に過去のものである。
興味深いのはVRAMから溢れているgemma4:26bでもVulkanが勝つこと、そしてgpt-oss:20bだけが逆転してROCm勝ちなことだ。MoEだから、という単純な話でもない(同じMoEの26bはVulkan勝ち)。カーネル実装とモデル構造の相性としか言いようがなく、これが「最後は自分のモデルで測れ」という結論の根拠になっている。
【本題2】プロンプト処理速度:長文を読ませるならROCm
次に、RAGや長文要約で効いてくるプロンプト処理速度。約2,000トークン(この記事の半分くらいの分量)を読み込ませた。
| モデル | 種別 | ROCm | Vulkan | 差 |
|---|---|---|---|---|
| gemma4(7.5B級) | dense | 2,797 tok/s | 2,371 tok/s | ROCm +18% |
| gpt-oss:20b | MoE | 1,316 tok/s | 2,881 tok/s | Vulkan +119% |
| qwen3:14b | dense | 1,546 tok/s | 1,331 tok/s | ROCm +16% |
| gemma4:26b(VRAM超過) | MoE | 730 tok/s | 414 tok/s | ROCm +76% |

今度はROCmが4モデル中3つで勝ち。生成速度とちょうど鏡写しの結果になった。とくにVRAM超過時(gemma4:26b)は差が76%まで開く。数千〜数万トークンの文書を読ませる使い方なら、この差は待ち時間として体感できるレベルだ。
そしてここでもgpt-oss:20bだけが真逆で、Vulkanが2.2倍という大差をつけた。gpt-ossを常用しているなら「生成もROCm、読み込みもVulkan」と、他のモデルと正反対の選択になる。面白いものである。
なお、Vulkanには「初回だけプロンプト処理が遅い」という癖がある。今回の計測でも、長文の1回目だけ他の回の3分の1程度の速度しか出なかった(2回目以降は安定)。シェーダーコンパイルによるウォームアップと思われる。Vulkanで測るときは1回目の数値を捨てること。
ここまでの数字は、すべて RX 9070 XT 16GB 一枚で出したものだ。バックエンドの選択で1〜4割は変わるが、そもそも「16GBに載るかどうか」が、その手前にあるもっと大きな分岐になる。これから組むなら、まずここが判断軸だ。
ポチップ
【検証】Flash Attentionの影響:生成には効かないが、読み込みには絶大
Ollamaは近年のバージョンでFlash Attention(FA)を自動有効化するが、環境変数OLLAMA_FLASH_ATTENTION=0で切ることもできる。オン/オフでどれだけ変わるかも測った(gemma4 7.5B)。
| 条件 | 生成速度 | プロンプト処理速度 |
|---|---|---|
| ROCm + FAオン | 69.3 tok/s | 2,797 tok/s |
| ROCm + FAオフ | 65.3 tok/s | 604 tok/s |
| Vulkan + FAオン | 100.2 tok/s | 2,371 tok/s |
| Vulkan + FAオフ | 102.0 tok/s | 530 tok/s |
生成速度はFAの有無でほぼ変わらない(±5%)。ところがプロンプト処理はFAオンで4.5〜4.6倍という劇的な差がつく。バックエンドを問わずだ。もし長文の読み込みが妙に遅いと感じたら、バックエンドを疑う前にFAが有効かを確認したほうがいい。ログにflash attention is enabledと出ていれば有効である。
【手順】バックエンドの切り替え方法
Ollama:環境変数で切り替える
Ollamaは起動時にバックエンドを自動選択する(筆者環境ではROCm)。強制的に切り替えるには、タスクトレイのOllamaを終了したうえで、環境変数OLLAMA_LLM_LIBRARYを設定してターミナルから起動する。
# Vulkanで起動する場合
$env:OLLAMA_LLM_LIBRARY = "vulkan"
ollama run gemma4:latest --verbose

# ROCmを強制する場合は "rocm_v7_1"(Ollamaのlib\ollamaフォルダ名に対応)これはそのターミナル内でのみ有効な一時設定だ。恒久化したいならsetxで設定してOllamaを再起動する。どちらで動いたかは%LOCALAPPDATA%\Ollama\server.logのinference compute行で確認できる。
LM Studio:ランタイムを選ぶだけ(CLIでも可)
LM StudioはGUIの設定(Runtime)でVulkan/ROCmを切り替えられるほか、実はCLI(lmsコマンド)でも操作できる。
# ROCmランタイムの導入(約210MB)
lms runtime get llama.cpp-win-x86_64-amd-rocm-avx2

# 切り替え
lms runtime select llama.cpp-win-x86_64-amd-rocm-avx2@2.23.1
切り替え後にモデルをロードし直せば反映される。
【検証】ツールが違うと結果は変わるのか:LM Studioでも測ってみた
OllamaもLM Studioも中身は同じllama.cppだ。では、ツールを変えても同じ結果になるのか。LM Studio側でも条件を揃えて(gemma4系7.5B・FAオン・dGPU固定・コンテキスト4096)両バックエンドを測った。
| 計測 | ROCm | Vulkan | 勝者 |
|---|---|---|---|
| Ollama:生成速度 | 69.3 tok/s | 100.2 tok/s | Vulkan |
| LM Studio:生成速度 | 76.3 tok/s | 107.4 tok/s | Vulkan |
| Ollama:プロンプト処理 | 2,797 tok/s | 2,371 tok/s | ROCm |
| LM Studio:プロンプト処理 | 3,812 tok/s | 2,886 tok/s | ROCm |
結果、勝敗の傾向は完全に一致した。 生成はVulkan、長文読み込みはROCm。このモデルに関しては、どちらのツールを使っていても選ぶべきバックエンドは同じ、ということだ。
絶対値はLM Studioのほうが1割ほど高く出ているが、これは同梱するllama.cppの世代差やバッチ設定の違いによるものだろう(プロンプト処理は計測方法も異なるため、ツール間の絶対値比較は参考程度に)。
ただし、これは「条件を揃えれば」の話である。 素の設定のままだと、話は大きく変わる。LM Studioのデフォルト(コンテキスト8192・並列4・Flash Attentionオフ)でROCmを測ると、生成66.8 tok/s・プロンプト処理はわずか247 tok/sまで落ちた。条件を揃えた場合(3,812 tok/s)と比べて15倍差である。ツールの差に見えるものの正体は、大半がデフォルト設定の差だ。LM Studioで長文を扱うなら、モデルロード設定でFlash Attentionをオンにしておくことを強くおすすめする。
【つまずきポイント】ベンチマークの落とし穴4連発
今回の計測では、数値がおかしくなる罠に立て続けにハマった。同じことを試す人のために共有しておく。
罠1:前のモデルがVRAMに残っている。 Ollamaは使い終わったモデルを既定で5分間VRAMに残す。この状態で別のモデルを測ると大幅に遅くなる(前回記事ではqwen3:14bが51→18 tok/sまで落ちた)。ollama stop モデル名でアンロードし、ollama psで空を確認してから測ること。
罠2:孤児プロセスがVRAMを占拠している。 Ollamaを再起動したつもりでも、ランナープロセス(llama-server.exe)が残ってVRAMを数GB掴んだままのことがある。実際、今回4.3GB掴んだ孤児のせいで初回の計測が全滅した。タスクマネージャーの「専用GPUメモリ」列か、次のコマンドで空きを確認してから計測を始めるとよい。
Get-Process -Name "ollama","llama-server" -ErrorAction SilentlyContinue | Stop-Process -Force罠3:LM StudioのVulkanが内蔵GPUを掴む。 これが今回最大のハマりポイントだった。Ryzen内蔵GPU(Radeon Graphics)があるマシンでは、LM StudioのVulkanランタイムがdGPUではなく内蔵GPU側でモデルを実行してしまうことがある。症状は「エラーは出ないのに異常に遅い」(筆者環境では5.3 tok/s。本来は107)。タスクマネージャーのGPU使用率を見ると、RX 9070 XTが暇をしていて内蔵GPUのComputeが張り付いている。対処はLM Studioの設定(ハードウェア)で内蔵GPUを無効化すること。ROCmランタイムは内蔵GPUを対象外として扱うため、この問題が起きない。ちなみにllama.cppの環境変数GGML_VK_VISIBLE_DEVICESはLM Studioには効かなかった(LM Studio側がデバイスリストを明示的に渡しているため)。スクリプトから制御したい人は、lmsのSDK(@lmstudio/sdk)でロード時にgpu: { disabledGpus: [1] }を指定すれば回避できる。
罠4:Vulkanの初回プロンプト処理は遅い。 前述のとおり、シェーダーコンパイルのため初回だけ数値が低く出る。ベンチマークでは1回目を捨てて2回目以降を採用すること。
【まとめ】「一度測って決めて、たまに測り直す」
お疲れ様でした!結果をまとめる。
【2026年9月】ドライバ更新後は生成も ROCm 優勢に逆転した。迷ったら ROCm。以下の箇条書きは7月時点のもの
- 生成速度はVulkan優勢(+23〜45%)。チャット中心なら「とりあえずVulkan」は今回も正解だった
- 長文の読み込みはROCm優勢(+16〜76%)。RAGや要約が主戦場ならROCmを選ぶ価値がある
- ただしモデルによって真逆になる(gpt-oss:20b)。常用モデルが決まったら自分で測るのが最終回答
- ツールを変えても傾向は同じ。OllamaとLM Studioで条件を揃えて測ったら、勝敗は完全に一致した
- ただしデフォルト設定の差は大きい。特にFlash Attentionは読み込み速度に絶大(4.5倍)。バックエンド以前にまずここを確認
- ドライバやランタイムの更新で結果は入れ替わりうる。「一度測って決めて、たまに測り直す」くらいの付き合い方がちょうどいい
測り方は本記事のとおり、--verboseのeval rate(生成)とprompt eval rate(読み込み)を見るだけだ。RX 9070 XTはどちらのバックエンドでも十分に速い。あとは自分の使い方に合わせて、速い方を選んでやればいい。
なお、この記事の数値はすべて下のカードで測っている。RadeonでローカルLLMを回すなら、16GBのRX 9070 XTは今のところかなり素直な選択肢だ。
ポチップ
関連記事もあわせてどうぞ。
参考文献


コメント