Radeon・ローカルAI

Radeon・ローカルAI

【実測】Qwen3.8-27B は RX 9070 XT 16GB で使えるか。GLM-4.7-Flash と並べたら、同じ27〜30Bでも3倍以上違った

2026年8月に公開された Qwen3.8-27B を、RX 9070 XT(VRAM 16GB)で実測した。同じ量子化(Q4_K_M)で GLM-4.7-Flash・Qwen3-Coder・Gemma 4 26B と並べたところ、ファイルサイズが大きいほうが3倍以上速いという逆転が起きる。dense と MoE の違い、MTP タグの効果、コンテキスト長を伸ばしても速度がほぼ変わらないこと、そして「同じ設定でも測り直すと数字が変わる」ところまで、全部実測値で示す。
Radeon・ローカルAI

【ROCm 10・Windows】RadeonでComfyUI環境構築【完全ガイド】

Windows の Radeon で ComfyUI を動かす手順は、ROCm 10 でかなり短くなった。インストーラは無いが、pip のコマンド2行で PyTorch まで入る。Python を 3.12 に落とす必要も無くなった。筆者は...
Radeon・ローカルAI

【実測】LM StudioでRadeonが「なぜか遅い」正体は内蔵GPU【RX 9070 XT・ランタイム2.37.0】

LM StudioでRadeonが異常に遅いとき、エラーは出ないのに内蔵GPUで動いていることがある。原因はランタイムごとにGPUの番号が入れ替わること。RX 9070 XTで実際に踏んだ症状(96 tok/sが16.5に落ちる)と確認方法、ランタイム2.23.1→2.37.0の実測3モデル分をまとめる。
Radeon・ローカルAI

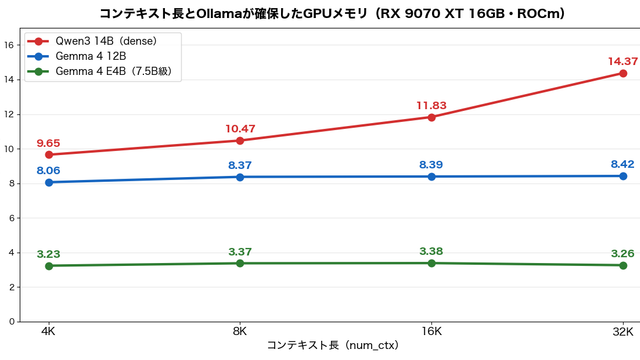
【実測】Ollamaのコンテキスト長を4Kから32Kにすると、VRAMと速度はどう変わるか【RX 9070 XT 16GB】

Ollamaのnum_ctxを4096から32768まで4段階で変えて、RX 9070 XT 16GBでVRAMと速度を実測した。生成速度は変わらず、落ちるのは読み込み速度。VRAMの増え方はモデルで全く違い、Qwen3 14Bは+4.7GB、Gemma 4 12Bは+0.4GBだった。16GBで長文を扱うための設定と、足りないときの逃げ道まで。
Radeon・ローカルAI

ローカルAI用のGPU、AMDとNVIDIAどっちを買う?RX 9070 XT を1年使った結論【2026年9月】

ローカルLLM・画像生成・動画生成のためにPCを買うなら、GPUはRadeonとGeForceのどちらか。RX 9070 XT 16GBを1年・14本の記事で実測してきた筆者が、用途別に「Radeonで足りる場面」と「NVIDIAにすべき場面」を正直に切り分ける。価格差と、その差額で何が買えるかまで。
Radeon・ローカルAI

【実測】ComfyUI高速化設定、ROCm 10で測り直したら半分が逆効果だった|効くのはMIOpenだけ

以前、RadeonでComfyUIを速くする4つの設定という記事を書いた。環境変数が2つ、起動オプションが1つ、そしてComfyUI本体のソースを書き換えるものが2つ。書き換えについては「ComfyUIをアップデートすると消える」と注意も書...
Radeon・ローカルAI

【実測】RX 9070 XT 16GBでローカル動画生成|6モデル試して、見るに耐えたのは1つだけ

前回、ROCm 10 を Windows の RX 9070 XT に入れた。FLUX.1 が3倍速くなったので、次に気になるのは当然これである。16GBのRadeonで、動画生成は動くのか。当ブログのRadeon記事は、画像生成とローカル...
Radeon・ローカルAI

【実測】ROCm 10をWindowsに入れた|FLUX.1が3.2倍、SD1.5は遅い

前回の記事で、ROCm 10 は「Windows対応と書いてあるが、配布物がまだ無い」と書いた。そして「配布されたら測って追記する」とも書いた。その前提が間違っていた。配布は既に始まっていた。探す場所が変わっていただけである。この記事では、...
Radeon・ローカルAI

【実測】M4 MacBook Air 24GBで画像生成はどこまで動くか。落ち方は実装で2倍違う

前回、このM4 MacBook Air 24GBでローカルLLMを動かし、ファンレスは熱で3割落ちるという結果を出した。では画像生成はどうか。落ちる。ただし落ち方が実装でまるで違った。冷えた状態から30枚連続で生成すると、Draw Thin...
Radeon・ローカルAI

【実測】M4 MacBook Air 24GBでローカルLLMはどこまで動くか。24GB積んでも使えるのは16GBだった

「メモリ24GBのMacなら、VRAM 16GBのグラボより大きいモデルが動くはずだ」そう思ってGemma 4を5サイズ全部試したところ、いちばん期待していた26Bが起動すらしなかった。しかもエラーを返さず、4分待たせて0トークン。原因を追...