ローカルLLMで長い文章を扱おうとして、こう聞いたことがあるはずだ。「コンテキスト長を上げるとVRAMが線形に増えて、速度も落ちる」。
英語圏の解説記事はだいたいそう書いている。4Kごとに1GB増える、32Kにすると8GB食う、といった目安つきで。筆者もそう思っていた。
ところが実際に測ったら、半分は当たっていて、半分は違った。速度は「生成」と「読み込み」で挙動がまったく違い、VRAMの増え方はモデルによって10倍以上の差があった。この記事は、その実測をそのまま出す。
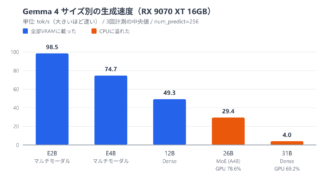
環境は RX 9070 XT 16GB / Windows 11 / Ollama 0.34.0。Gemma 4 の5サイズを測った記事で「コンテキスト長4,096での計測。長文脈にするとさらに不利になるはず」と書いて宿題にしていた。それを回収する。
【結論】生成は落ちない。落ちるのは読み込み。VRAMはモデル次第
先に結論から。
- 生成速度(tok/s)は、4Kでも32Kでも変わらない。3モデルとも誤差の範囲
- 落ちるのは読み込み速度で、Qwen3 14Bは32Kで1/5になった(1,921 → 411 tok/s)
- VRAMの増え方はモデルで全然違う。Qwen3 14Bは4K→32Kで+4.7GB、Gemma 4 12Bは+0.4GB
- 16GBでQwen3 14Bを32Kで使うと14.37GB。載るが余裕は無い。KVキャッシュをq8_0にすれば2割減る
「上げると遅くなる」は、長文を貼ってから最初の1文字が出るまでの待ちが伸びるという意味では正しい。ただし、出始めてからの速さは変わらない。そして「線形に増える」は、Qwen3には当てはまり、Gemma 4には当てはまらなかった。
【前提】測り方
| 項目 | 内容 |
|---|---|
| GPU | Radeon RX 9070 XT 16GB(gfx1201) |
| CPU / メモリ | Ryzen 9 7900X / DDR5 64GB |
| OS | Windows 11 |
| Ollama | 0.34.0(同梱の ROCm ランタイム) |
| KVキャッシュ | f16 / Flash Attention オン |
| コンテキスト長 | 4,096 / 8,192 / 16,384 / 32,768 の4段階 |
| 計測 | 生成: 300トークン × 4回。読み込み: コンテキスト長に合わせた長文(約2,600〜24,500トークン)× 4回。いずれも初回を捨てて中央値 |
| 日付 | 2026年9月14日・無人で一括実行 |
モデルは3つ。Qwen3 14B(dense)、Gemma 4 12B、Gemma 4 E4B(7.5B級・Ollamaの gemma4:latest)。どれも4Kの時点で16GBに載る。gpt-oss:20bと26B以上は、4Kの時点でVRAMに余地が無いので今回は外した。
「読み込み」と「生成」は分けて測っている。読み込み(pp)は貼り付けた文章を処理する速さ、生成(tg)はそのあと返事を書く速さ。長文を扱うとき体感が変わるのは前者で、チャットの心地よさを決めるのは後者である。
【VRAM】Qwen3は+4.7GB、Gemma 4は+0.4GB

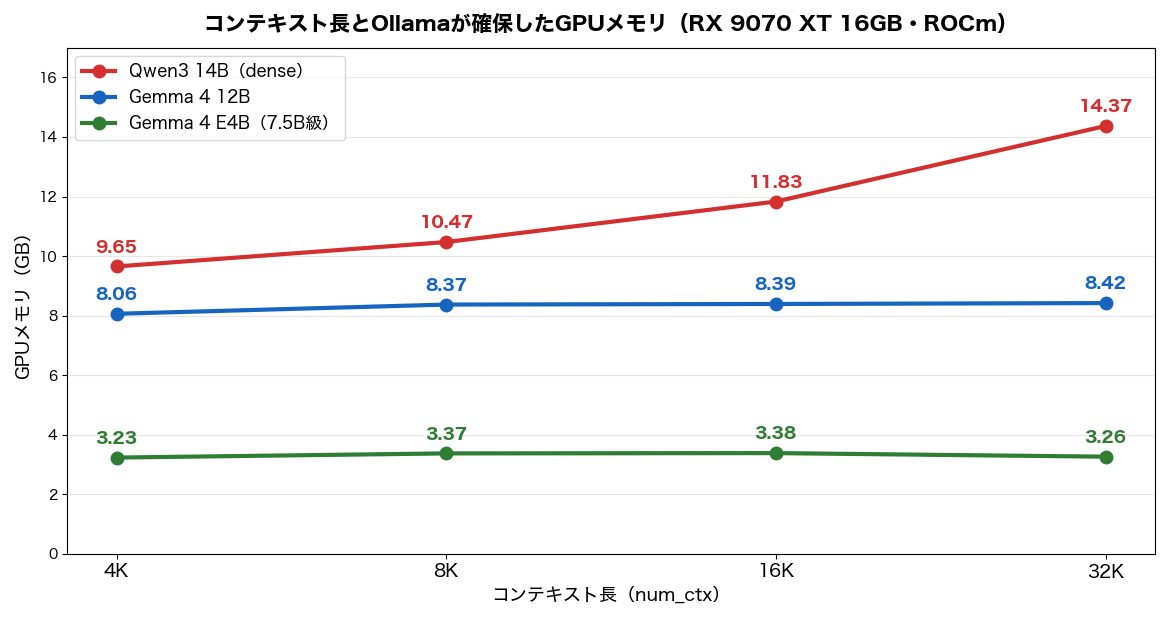
Ollamaがそのモデルに割り当てたGPUメモリ(ollama ps の値)を、コンテキスト長ごとに並べた。
| コンテキスト長 | Qwen3 14B | Gemma 4 12B | Gemma 4 E4B |
|---|---|---|---|
| 4K | 9.65GB | 8.06GB | 3.23GB |
| 8K | 10.47GB | 8.37GB | 3.37GB |
| 16K | 11.83GB | 8.39GB | 3.38GB |
| 32K | 14.37GB | 8.42GB | 3.26GB |
| 4K→32Kの増分 | +4.72GB | +0.36GB | +0.03GB |
Qwen3 14Bは、定説どおりに増える。4Kから32Kで4.7GB。8K刻みで見ると+0.8 / +1.4 / +2.5GBと、増分自体が大きくなっていく。16GBのGPUだと32Kで14.37GBで、載りはするが、他のアプリがGPUを使っていると溢れる。
Gemma 4 12Bは、ほとんど増えない。4Kから32Kで0.36GB。同じ32Kで、Qwen3より6GB近く少ない。E4Bに至っては誤差の範囲で動いていない。
この値について1つ注記しておく。ollama ps の値はOllamaがモデルに割り当てる量で、載るか載らないかの判定にOllama自身が使う数字である。一方でWindowsのGPUパフォーマンスカウンタが見せる実使用のピークは、コンテキスト長を変えてもほとんど動かなかった。どちらが正しいかは追い切れていないが、Qwen3 14Bの公開されている構成(40層・KVヘッド8・ヘッド幅128・f16)から計算するとKVキャッシュは1トークンあたり約160KBで、4Kから32Kへの増分28,672トークン分は約4.7GB。Ollamaの値と一致する。載るかどうかを決めるのはOllama側の値なので、この記事はそれを使う。
つまり「コンテキストを伸ばすとVRAMが線形に増える」は、モデルの設計に依存する話であって、一般法則ではない。16GBで長い文章を扱いたいなら、Qwen3よりGemma 4のほうが余裕がある。この差は、モデルの賢さや速さとは別の軸なので、用途によっては選択が変わる。
なぜGemma 4は増えないのか
筆者の理解では、Gemma系は多くの層がスライディングウィンドウ型の注意機構を使っていて、それらの層のKVキャッシュはコンテキスト全体ではなく一定幅の窓の分しか持たない。全文を見る層は一部だけなので、コンテキストを伸ばしてもキャッシュの総量があまり増えない。Qwen3は全層が全文を見る設計なので、KVキャッシュがコンテキスト長に比例する。
これはモデルカードとアーキテクチャの説明から筆者が読み取ったもので、Ollama側の実装まで追ったわけではない。確かなのは実測値のほうで、理由は「たぶんこう」の範囲として読んでほしい。
【速度】生成は動かない。読み込みは落ちる

生成速度(tg)── 4Kでも32Kでも同じ
| コンテキスト長 | Qwen3 14B | Gemma 4 12B | Gemma 4 E4B |
|---|---|---|---|
| 4K | 52.8 | 60.1 | 103.0 |
| 8K | 48.9 | 60.1 | 102.9 |
| 16K | 47.9 | 60.3 | 102.5 |
| 32K | 50.0 | 60.2 | 103.1 |
単位は tok/s。3モデルとも、4Kと32Kで差が無い。Qwen3が4Kだけ少し高いが、日次変動が1〜2割ある環境なので、これを傾向とは読まない。
つまり、コンテキスト長を上げても「返事が遅くなる」ことは無い。チャットで長い履歴を保ったまま使いたいなら、num_ctxを上げるコストは生成側にはかからない。
読み込み速度(pp)── Qwen3は32Kで1/5
| コンテキスト長 | Qwen3 14B | Gemma 4 12B | Gemma 4 E4B |
|---|---|---|---|
| 4K | 1,921 | 1,955 | 4,859 |
| 8K | 1,049 | 1,898 | 4,825 |
| 16K | 796 | 1,735 | 4,384 |
| 32K | 411 | 1,440 | 3,454 |
| 4K→32K | −79% | −26% | −29% |
こちらは落ちる。Qwen3 14Bは4Kで1,921 tok/sだったのが、32Kで411 tok/s。今回の計測で貼った約3万トークンの文章だと、読み終わるまで約70秒かかる計算になる。Gemma 4は落ち幅が小さく、12Bで−26%、E4Bで−29%。
「コンテキストを上げると遅くなる」という体感の正体はこれだ。長い文章を貼ってから最初の1文字が出るまでの待ち時間が伸びる。出始めてからは変わらない。だから、短いやり取りを長く続けるチャット用途なら影響は小さく、論文や長いログを一気に読ませる用途なら効いてくる。
Qwen3の落ち幅がGemma 4より大きいのも、VRAMと同じ理由だと思われる。全層が全文を見る設計は、文章が長くなるほど処理量が増える。
【設定】num_ctxの変え方は3つ
Ollamaの既定は筆者の環境では 4,096 だった(7月に ollama ps で確認)。何も設定しないと、貼った文章がここで切られる。しかもエラーは出ない。黙って切られる。長文を貼ったのに前半を無視した返事が来るときは、だいたいこれが原因だ。
変え方は3つある。
1. その場で変える(CLIのセッション内)
/set parameter num_ctx 327682. モデルに焼き込む(Modelfileで別名を作る)
FROM qwen3:14b
PARAMETER num_ctx 32768
ollama create qwen3-32k -f Modelfileこれで qwen3-32k という名前で呼べば常に32Kになる。VSCodeの拡張など、外部ツールから呼ぶときはこの方法が確実である。
3. APIで毎回渡す
{ "model": "qwen3:14b", "prompt": "...", "options": { "num_ctx": 32768 } }自作のスクリプトから叩くならこれでいい。
どの方法でも、設定が効いているかは ollama ps で確認できる。確保されたメモリの量が変わっていれば効いている。
【つまずき】上限を超えると黙って丸められる。Vulkanだと読み込みが壊滅する
実際に踏んだものを3つ。
1. 既定の4,096で切られていることに気づかない。上に書いたとおり、エラーが出ない。「なんか前半を読んでない」と感じたら ollama ps を見る。
2. モデルの上限を超える値を指定すると、黙って上限に丸められる。7月にQwen3 14Bへ65,536を指定したとき、サーバーログに警告が出て、実際には40,960(そのモデルの学習時の上限)に丸められていた。設定した値が効いていると思い込んで使うと、計算が合わなくなる。ollama ps の値と、モデルカードの上限を照らし合わせること。
3. Vulkanバックエンドだと、読み込み速度が壊滅する。同じ計測をVulkanで回すと、Qwen3 14Bの32Kは411ではなく300 tok/s、Gemma 4 12Bは1,440ではなく215 tok/sだった。生成速度もROCmの半分程度で、これは別の記事で切り分けたとおり、AMDドライバの更新後に起きた変化である。長文を扱うなら、いまはROCmを選ぶ。筆者の環境ではOllamaが自動でROCmを選んでいるので、明示的にVulkanへ切り替えていなければ気にしなくてよい。
【16GBで足りない時】KVをq8_0にする、メモリを積む、GPUを替える
Qwen3 14Bを32Kで使うと14.37GB。ここから先の逃げ道を、効く順に書く。
1. KVキャッシュをq8_0にする。環境変数 OLLAMA_KV_CACHE_TYPE=q8_0 を設定すると、KVキャッシュが半分の精度になる。7月に別モデル(Qwen2.5-Coder 14B・32K)で測ったときは、VRAMが15.14GB → 12.18GBで−19.5%、生成速度は−1.8%だった。精度の低下は筆者の用途では体感できていない。まずこれを試す。筆者は恒久設定にしている。
2. Gemma 4に替える。上の表のとおり、同じ12B級でもGemma 4は32Kで8.42GB。Qwen3から6GB減る。モデルの向き不向きはあるが、「長文を読ませる」のが主目的なら候補に入る。
3. メインメモリを64GBにする。VRAMから溢れた分はメインメモリに行く。速度は大きく落ちるが、動かないよりはいい。筆者の構成は64GBで、画像生成や動画生成でもこれが効いた。

4. GPUを替える。24GB以上あれば、Qwen3 14Bの32Kは余裕で載り、26B級も視野に入る。PCごと組み直すなら、GPUとメモリ64GBを先に決めて、残りは予算に合わせればいい。

5. 統合メモリという別解。Ryzen AI Max+ 395のミニPCは統合メモリを128GB積める構成があり、VRAMの壁そのものが無い。ただし筆者は持っておらず、速度は測っていない。「大きいコンテキストを、速くなくていいから」という人向けに名前だけ置く。
【まとめ】num_ctxは上げていい。ただしモデルを見て決める
お疲れ様でした。実測から言えることをまとめる。
- 生成速度はコンテキスト長で変わらない。上げることに生成側のコストは無い
- 読み込み速度は落ちる。Qwen3 14Bは32Kで1/5。長文を一気に貼る用途で効く
- VRAMの増え方はモデルで10倍違う。Qwen3 14Bは+4.7GB、Gemma 4 12Bは+0.4GB
- 16GBでQwen3 14Bの32Kは14.37GBで載る。KVをq8_0にすれば2割減る
- 既定の4,096は黙って切る。
ollama psで確保量を見る癖をつける
「コンテキストを伸ばすとVRAMが線形に増える」という定説は、Qwen3では正しく、Gemma 4では外れていた。目安で判断せず、使うモデルで一度 ollama ps を見る。それだけで、16GBでできることの範囲がかなり変わる。
Radeonでの導入から先は全手順まとめから辿れる。

コメント