
LM StudioでRadeonを使っていて、「エラーは出ないのに、なぜか異常に遅い」という状態になったことはないだろうか。
筆者は2回踏んだ。1回目は7月、VulkanとROCmを比べた記事で「Vulkanが内蔵GPUを掴む」と書いた。2回目は9月、今度はROCmのほうが内蔵GPUを掴んだ。同じマシン、同じ設定のつもりで、Gemma 4 E4Bが本来96 tok/s出るところ16.5 tok/sしか出なかった。
2回目で原因が分かった。ランタイム(ROCm / Vulkan)によって、GPUに振られる番号が入れ替わる。片方で正しい設定が、もう片方では内蔵GPUを指している。この記事はその確認方法と、ついでに測り直したランタイム2.23.1→2.37.0の速度をまとめる。
【結論】GPUの番号はランタイムごとに違う。切り替えたら必ず確認する
- ROCmランタイムでは内蔵GPUが0番、RX 9070 XTが1番。Vulkanランタイムでは逆(筆者環境・2026年9月)
- 間違った番号で動くと、エラーは出ずに速度だけ1/6になる(E4B: 96 → 16.5 tok/s)
- 確認は
lms runtime survey。ランタイムを切り替えるたびに見る - ランタイム2.23.1→2.37.0で、ROCmは生成+5%前後。12BのVulkanは2.23.1でもすでに崩れていた=原因はランタイムではなくドライバ
【症状】エラーは出ない。ただ遅い
Ryzenのデスクトップには、CPUに内蔵GPU(Radeon Graphics)が付いている。LM StudioはこれもGPUとして認識する。だからモデルを載せる先が2つある状態になっていて、設定を間違えると内蔵GPUのほうに載る。
内蔵GPUでもモデルは動く。動くから、エラーが出ない。ただし速度が桁で落ちる。9月の実測ではこうだった。
| 載った先 | Gemma 4 E4B の生成速度 |
|---|---|
| RX 9070 XT(正しい) | 96.0 tok/s |
| 内蔵GPU(間違い) | 16.5 tok/s |
設定を1つ間違えるだけで1/6になる。「Radeonは遅い」と感じてローカルLLMを諦めた人の何割かは、これを踏んでいるのではないかと思う。
【原因】ROCmとVulkanで、GPUの番号が入れ替わる
LM Studioには、モデルを載せるGPUを番号で指定する設定がある。問題は、その番号がランタイムごとに違うことだ。
筆者の環境で lms runtime survey(LM StudioのCLI)を実行すると、こう出た。この出力はいま選択しているランタイムの分だけで、上の行が0番、次が1番である。lms runtime select でランタイムを切り替えてもう一度実行すると、並びが逆になる。
| ランタイム | 0番 | 1番 |
|---|---|---|
| llama.cpp ROCm | 内蔵GPU(Radeon Graphics) | RX 9070 XT |
| llama.cpp Vulkan | RX 9070 XT | 内蔵GPU |
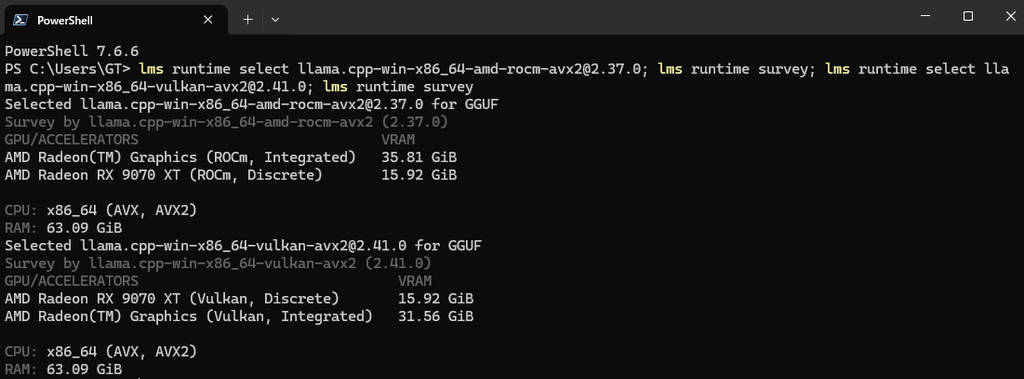
同じマシンなのに、並び順が逆。ROCmで「1番を使う」と設定すればRX 9070 XTに載るが、その設定のままVulkanに切り替えると内蔵GPUに載る。逆も同じである。
さらにややこしいことに、この並び順は7月と9月で変わっていた。7月はROCm側でRX 9070 XTが0番だった。間にAMDのドライバを更新しているので、おそらくそのせいだと思うが、確証は無い。つまり「一度合わせたから大丈夫」ではなく、ランタイムを変えたときとドライバを更新したときは、毎回見直す必要がある。
7月に「Vulkanが内蔵GPUを掴む」と書いたのも、9月に「ROCmが掴んだ」のも、原因はこれ1つだった。
【確認】lms runtime survey と、速度の桁
確認は2段階でいい。
1. lms runtime survey で並びを見る。LM StudioをインストールするとCLIの lms が入る。ターミナルで実行すると、選択中のランタイムでのGPUの一覧が出る(上から0番、1番)。RX 9070 XTが何番かを確認して、設定のGPUをそこに合わせる。
2. 生成速度の桁を見る。モデルを載せて何か生成させ、tok/sを見る。Gemma 4 E4Bなら、RX 9070 XTで100前後、内蔵GPUで15前後。桁が違うので、数字を覚えておけば一目で分かる。自分の環境で1回だけ正しい速度を測っておくと、以後の異常にすぐ気づける。
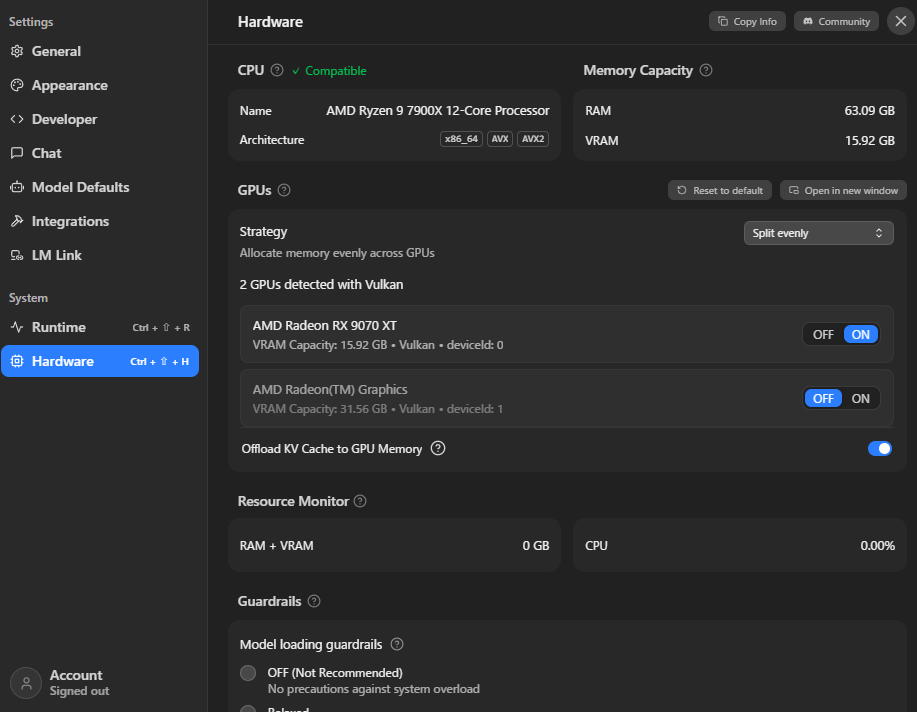
筆者はベンチをスクリプトから回しているので、lms runtime survey の出力から「9070」を含む行の番号を拾って自動で指定するようにした。GUIで使う人は、設定のHardware(ハードウェア)からGPUを選ぶ。内蔵GPUを無効にしてしまうのが、いちばん確実である。
【測り直し】ランタイム2.23.1→2.37.0で何が変わったか
ついでに、LM Studioのランタイムを7月と同じ 2.23.1 と、9月14日時点の最新 2.37.0 で測り直した(その後 2.41.0 が出ている。未計測)。どちらも正しいGPUに載せた状態で、Gemma 4の3モデル。生成は300トークン×4回、初回を捨てた中央値。
生成速度(tok/s)
| モデル | ROCm 2.23.1 | ROCm 2.37.0 | Vulkan 2.23.1 | Vulkan 2.37.0 |
|---|---|---|---|---|
| Gemma 4 E4B | 99.0 | 103.9 | 129.2 | 134.6 |
| Gemma 4 12B | 58.5 | 61.2 | 28.7 | 28.9 |
| Gemma 4 26B(MoE) | 40.3 | 39.7 | 36.4 | 36.6 |
2.23.1から2.37.0で、ROCmは4〜5%上がった。E4BとVulkanも同じくらい。26Bは動かない。ランタイム更新の効果はあるが、小さい。
もう1つ大事なことがある。12BのVulkanは、2.23.1の時点ですでに28.7に崩れている。7月に測ったときはVulkanのほうが速かったモデルだ。同じランタイムで同じモデルが半分以下になっているので、原因はLM Studioのランタイムではなく、その間に更新したAMDドライバである。これはOllama側で切り分けた結論と一致する。
7月からの変化(E4B・ROCm)
| 時点 | ランタイム | 生成 tok/s |
|---|---|---|
| 7月 | 2.23.1 | 76.3 |
| 9月 | 2.23.1 | 99.0 |
| 9月 | 2.37.0 | 103.9 |
同じランタイム2.23.1で、7月の76.3が9月に99.0になっている。ランタイムを変えていないのに3割上がった。これもドライバ側の変化で、Vulkanのdense崩壊と同じ更新で、ROCmのほうは底上げされている。ドライバの更新は、速くなる方向にも遅くなる方向にも効く。だから測り直す。
VulkanとROCm、どっちを選ぶか(LM Studio・2026年9月)
上の表をそのまま読めばいい。E4BのようなサイズならVulkan、12B以上はROCm。モデルの大きさで勝者が変わる。これはOllamaで出た結論と同じで、中身が同じllama.cppなので当然ではある。
なお、読み込み速度(プロンプト処理)もあわせて測ったが、LM Studioの値は最初の1文字が出るまでの時間から逆算したもので、Ollamaの値とは絶対値を直接比べられない。傾向だけ書くと、ROCmがVulkanの1.5〜3倍で、7月と変わらない。
【足りない時】内蔵GPUは切って、RX 9070 XTの16GBを全部使う
内蔵GPUを掴む問題を潰したうえで、それでも「16GBに載らない」となったら、次は別の話になる。26B級はVRAMから溢れて速度が落ちるし、32K以上のコンテキストはモデルによってVRAMを食う。そこから先の逃げ道はGemma 4の5サイズを測った記事に書いた。
GPUごと替えるなら、AMDとNVIDIAどっちを買うかの記事で用途別に切り分けてある。BTOで組むなら、GPUとメモリ64GBを先に決める。

 ポチップ
 ポチップ


【まとめ】遅いと思ったら、まずGPUの番号
お疲れ様でした。
- LM Studioは内蔵GPUもGPUとして数える。間違うとエラー無しで速度が1/6
- ROCmとVulkanでGPUの番号が入れ替わる。片方で正しい設定はもう片方で間違い
- 並び順はドライバ更新でも変わる。ランタイムを変えたとき・ドライバを更新したときは
lms runtime survey - 自分の環境の「正しい速度」を1回測って覚えておく。桁で分かる
- ランタイム2.37.0はROCmで+5%。12BのVulkan崩壊はランタイム以前からで、ドライバが原因
「Radeonは遅い」と結論を出す前に、どのGPUで動いているかを1回見てほしい。筆者は2回それで時間を溶かした。
コメント