
「メモリ24GBのMacなら、VRAM 16GBのグラボより大きいモデルが動くはずだ」
そう思ってGemma 4を5サイズ全部試したところ、いちばん期待していた26Bが起動すらしなかった。しかもエラーを返さず、4分待たせて0トークン。
原因を追いかけたら、24GB積んでいてもGPUが使えるのは既定で16.0 GiBだけだと分かった。RX 9070 XT(15.9 GiB)とほぼ同じ土俵に立たされていたのである。
この記事では、5サイズの実測値と、26Bを動かすための設定、そしてファンレスMacBook Airが4分で3割遅くなるという、デスクトップのベンチマークでは絶対に出ない数字を出す。
【結論】既定のままなら12Bまで。26Bはsysctlが要る
| サイズ | 生成速度 | GPU割当 | 既定16 GiBで動くか |
|---|---|---|---|
| E2B | 51.1 tok/s | 1,397 MiB | ○ |
| E4B | 28.5 tok/s | 2,829 MiB | ○ |
| 12B | 12.3 tok/s | 7,024 MiB | ○ |
| 26B A4B | 失敗 → 23.0 tok/s | 16,147 MiB | ✗ 68 MiB足りない |
| 31B Dense | 実用外 | — | ✗ スワップで機械が止まる |
用途で選ぶならこうなる。
| やりたいこと | 選ぶべきサイズ | 理由 |
|---|---|---|
| 常駐させて即答させたい | E2B | 51.1 tok/s。1.4GBしか使わない |
| 迷ったらこれ | E4B | 28.5 tok/s。設定変更なしで最速クラス |
| 設定を変えてもいいなら | 26B | 23.0 tok/s で12Bの1.8倍。ただしsysctlが要る |
| 賢さ重視・設定はいじりたくない | 12B | 12.3 tok/s |
| — | 31Bは非推奨 | 24GBでは機械ごと止まる |
【最大の罠】24GB積んでも、GPUに回るのは16 GiB
Ollamaのサーバログを見ると、最初にこう出る。
inference compute  library=Metal  name=MTL0  description="Apple M4"
  type=iGPU  total="16.0 GiB"  available="16.0 GiB"
24GBのうち、GPUが使えるのは16.0 GiB。 macOSが既定で物理メモリの約3分の2しか割り当てないためだ。残りの8GBは目の前にあるのに使えない。
これがどれだけ紛らわしいかというと、比較対象にした RX 9070 XT は 15.9 GiB。差は0.1 GiBである。「24GBのMacを買えば16GBのグラボより余裕がある」という期待は、既定のままでは成立しない。
【罠の実害】26Bは68 MiB足りずに、エラーも出さず4分待たせる
26Bを動かそうとしたときのログがこれだ。
load_tensors: MTL0_Mapped model buffer size = 16147.34 MiB

memory breakdown [MiB] | total   free    self  (model + context + compute)
  - MTL0 (Apple M4)    | 16384 = 16383 + (16452 = 16147 +     201 +     103)

WARN  llama-server startup failed with projector GPU offload;
      retrying with projector CPU offload
INFO  disabling multimodal projector offload  reason=startup-oom-retry
必要なのは16,452 MiB、枠は16,384 MiB。差は68 MiB、率にして0.4%。
たったこれだけ足りないせいでOOMし、Visionプロジェクタ(clip・572.79M)をCPUに逃がして再起動し、それでも失敗する。
最悪なのは失敗の仕方だ。
slot release: stop processing: n_tokens = 26, truncated = 0
[GIN] 200 |  3m53s | POST "/api/generate"
n_tokens = 26 はプロンプト分だけで、生成は0トークン。それでもHTTPは 200(成功) を返す。つまり 3分53秒待たされた挙句、何も返ってこないのにエラーも出ない。原因を知らなければ、ただ「Macは遅い」と思って終わる。
【解決】sysctlで枠を広げると、26Bは23.0 tok/sで動く
macOSにはこの割り当てを変えるノブがある。
sudo sysctl iogpu.wired_limit_mb=20480GPU枠を20 GiBに広げる。再起動で元に戻る一時設定なので、システムを恒久的に変更するわけではない。実行後、Ollamaを再起動すると認識が変わる。
inference compute ... total="20.0 GiB" available="20.0 GiB"結果はこうなった。
| サイズ | 16 GiB | 20 GiB | 差 |
|---|---|---|---|
| E2B | 51.13 | 51.73 | +1.2% |
| E4B | 28.52 | 28.65 | +0.5% |
| 12B | 12.33 | 12.74 | +3.3% |
| 26B | 失敗 | 23.04 | 動くようになった |
小さい3モデルは誤差範囲でしか変わらない。 もともと枠に余裕があったので当然だが、これを確認しておかないと「枠を広げたら全部速くなった」と誤読しかねない。変わったのは26Bだけである。
値の選び方
24GBのうち20GBをGPUに回すと、システム側には4GBしか残らない。ブラウザを何枚も開いていると厳しいので、26Bを動かすだけなら18432(18 GiB)で足りる(必要量は16.5GB)。戻すときは sudo sysctl iogpu.wired_limit_mb=0 か再起動。
【意外】26Bは12Bより1.8倍速い
枠さえ足りていれば、26Bは12Bを大きく上回る。
12B (dense 11.95B)   12.7 tok/s
26B (MoE   25.2B)    23.0 tok/s   ← パラメータ2倍以上なのに1.8倍速い
理由はMoE(Mixture-of-Experts)の構造にある。公式モデルカードによれば 26B A4B は合計25.2Bのうちアクティブは3.8Bで、エキスパートの構成は「8 active / 128 total and 1 shared」だ。推論はメモリ帯域律速なので、「毎トークンで何バイト読むか」が速度を決める。
有効パラメータ順に並べると、速度がきれいに対応する。
| モデル | 毎トークンで使う量 | 生成速度 |
|---|---|---|
| E2B | 2.3B(有効・合計5.1B) | 51.7 tok/s |
| 26B | 3.8B(アクティブ・合計25.2B) | 23.0 tok/s |
| E4B | 4.5B(有効・合計8B) | 28.6 tok/s |
| 12B | 11.95B(dense・全部) | 12.7 tok/s |
ただし26Bだけ、理屈より遅い。3.8BしかないのにE4B(4.5B)に負けている。実効帯域を概算するとこうだ。
M4 MacBook Air のメモリ帯域は公式スペックで 120GB/s。それに対する到達率はこうなる。
| モデル | 実効帯域の目安 | 120GB/sに対して |
|---|---|---|
| 12B | 約91 GB/s | 76% |
| E4B | 約77 GB/s | 64% |
| E2B | 約71 GB/s | 59% |
| 26B | 約52 GB/s | 43% |
denseの12Bが76%まで使えているのに対し、26Bは43%しか引き出せていない。エキスパートを毎回選んで散らばった場所を読むぶん、連続領域を舐めるdenseよりアクセス効率が落ちるためと思われる。
なお、この実効帯域は Q4_K_M を約0.56バイト/パラメータとして概算したもので、厳密な値ではない。モデル間の相対比較として読んでほしい。
そして26Bの厄介さは「読む量は少ないのに、25.2B全部を常駐させないと動かない」点にある。 速いのにメモリだけは大食いで、既定の枠に入らない。Macで一番おいしいモデルが、一番設定に敏感なのである。
【限界】31Bはメモリを増やしても無理。機械ごと止まる
31Bは数字を取ることすらできなかった。
| 項目 | 実測 |
|---|---|
| プロンプト処理 | 1.11 tok/s(26トークンに23.3秒) |
| 256トークン生成 | 5分超で完走せず |
| スワップ | 11,551 MB / 12,288 MB(94%) |
| メモリ空き | 12% |
| ページアウト | 2,022,747 |
| 体感 | 文字入力がカクつく |
ここがユニファイドメモリの怖いところだ。比較対象のRadeon環境は VRAM 16GB + メインRAM 64GB なので、31Bが溢れても4.0 tok/sに落ちるだけでPC自体は普通に使えた。
Macでは溢れた先がメインメモリで、そこも足りなくなるとSSDのスワップに行く。結果として、LLMが遅くなるのではなく、機械そのものが使えなくなる。 文字入力までカクつく状態で、記事を書くことも調べ物をすることもできない。
「メモリが共有だから大きいモデルが動く」は、限界を超えると逆に働く。
【ノートPC固有】4分で3割遅くなる
ここがデスクトップのベンチマークでは絶対に出ない部分だ。
MacBook Airはファンレスである。 12Bを間を空けずに14回連続で回し、powermetrics でGPU周波数とThermal pressureを同時に記録した。
| 経過 | 生成速度 | GPU周波数 | Thermal pressure |
|---|---|---|---|
| 67s | 12.6 tok/s | 1,468 MHz | Nominal |
| 89s | 12.3 | 1,469 MHz | Nominal |
| 110s | 12.4 | 1,462 MHz | Nominal |
| 131s | 12.1 | 1,390 MHz | Moderate |
| 153s | 12.0 | 1,340 MHz | Heavy |
| 176s | 11.1 | 1,210 MHz | Heavy |
| 202s | 10.0 | 1,010 MHz | Heavy |
| 231s | 9.2 | 886 MHz | Heavy |
| 289s | 8.9 | 792 MHz | Heavy |
| 347s | 9.1 | 770 MHz | Heavy |
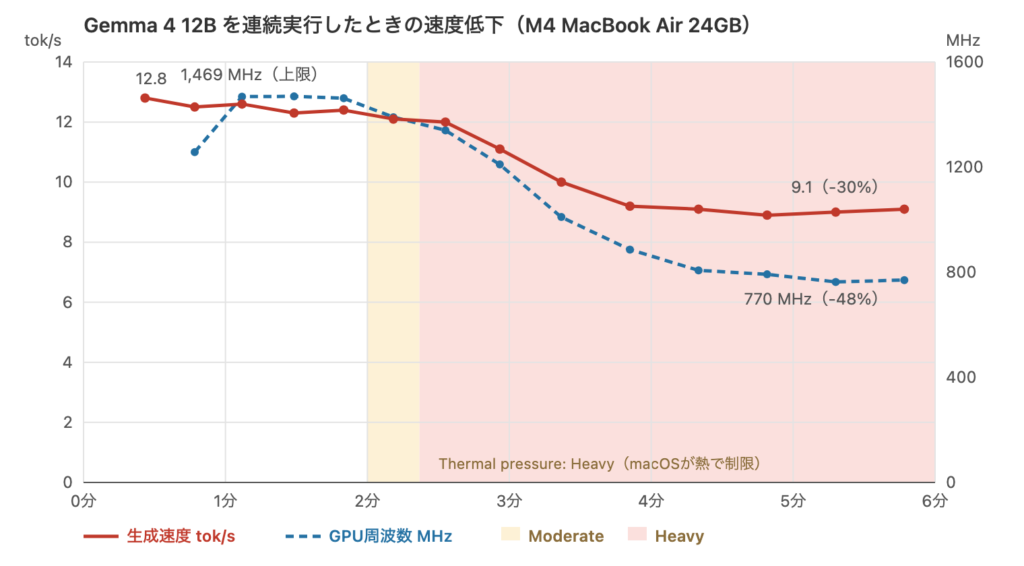
読み取れることは3つある。
- 最初の約2分は全速で走る。 GPUは上限の1,469MHzに張り付き、12.3〜12.6 tok/sを保つ。短い質問を投げる分にはカタログどおりの速度が出る。
- 131秒でmacOSが制限を始める。 Thermal pressureがModerateになり、クロックが1,390MHzへ落ち始める。153秒でHeavyが常時化する。これは推測ではなく、macOS自身が「熱で制限中」と報告している値だ。
- 約4分で底を打ち、9.0 tok/s前後で安定する。 12.4から9.0へ、約30%の低下である。
面白いのは低下率の非対称だ。
GPUクロック  1,469 → 763 MHz   -48%
生成速度      12.4 → 9.0 tok/s  -30%
クロックが半分になっても速度は3割減で済んでいる。 推論がメモリ帯域律速で、演算クロックの低下がそのまま効かないためだ。
なお、モデルごとに90秒の間隔を空けて測ったときは、814サンプル全てがNominalだった。連続で使ったときだけ起きる現象である。
つまり実用上の意味はこうなる。チャットで短く聞く分には12.4 tok/s、長文を書かせ続けたり連続で作業させるなら9.0 tok/sが実力。 ノートPCでローカルLLMを回すなら、カタログ値ではなく後者で考えたほうがいい。
RX 9070 XT 16GBとの比較
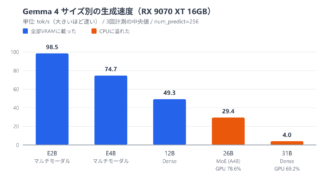
同じプロンプト・同じ設定で測った既存記事の数字と並べる。
| サイズ | RX 9070 XT 16GB | M4 MBA 24GB | 比 |
|---|---|---|---|
| E2B | 98.5 tok/s | 51.1 tok/s | 0.52× |
| E4B | 74.7 | 28.5 | 0.38× |
| 12B | 49.3 | 12.3 | 0.25× |
| 26B | 29.5 | 23.0(20 GiB時) | 0.78× |
| 31B | 4.0 | 実用外 | — |
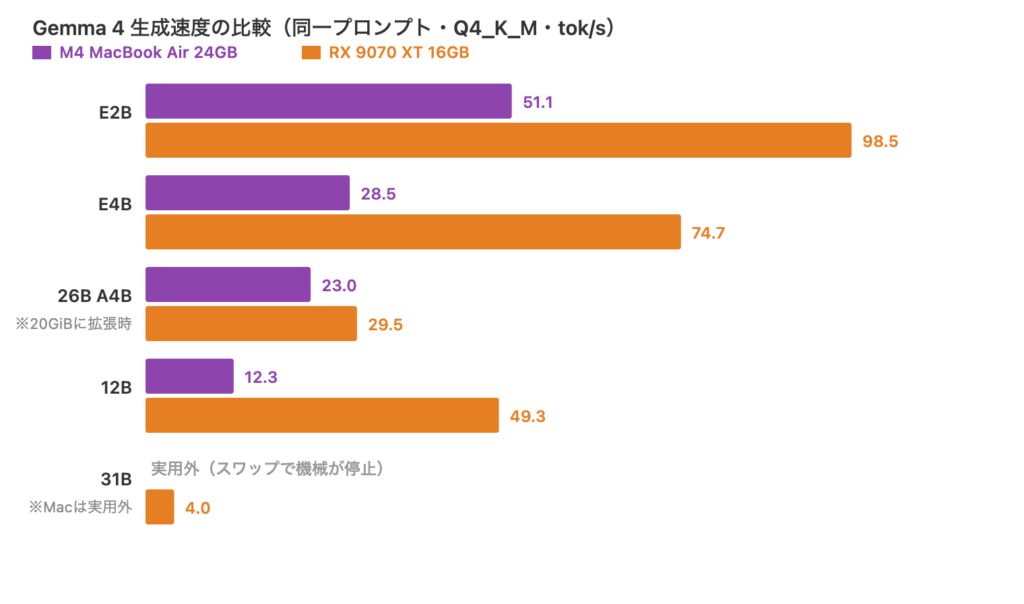
おおむね4分の1から半分。 ただし26Bだけ0.78倍と健闘しているのは、Radeon側では26Bが16GBから溢れて速度を落としていたのに対し、Mac側は20 GiBに広げて全部載せられたからだ。枠さえ足りれば、MoEはMacでよく走る。
この「CPUとGPUでメモリを共有する」作りは、Windows 側にもある。Ryzen AI Max+ 395 を積んだミニPCで、GMKtecのEVO-X2なら64GBと128GBの構成がある(2026年10月時点の公式セール価格は64GB版で34万7,999円から)。
筆者は持っていないので測っていないが、31B のような「24GBのMacでは機械ごと止まる」サイズを載せたい人の候補になる。
消費電力と静音性、そして持ち運べることを考えれば、この差をどう見るかは用途次第だろう。少なくとも 「MacBook AirでローカルLLMは動かない」は間違いで、E4Bクラスなら出先で十分に実用になる。

実際の出力
同じプロンプト(「ローカルLLM初心者にVRAMの重要性を専門用語なしで説明して」)への冒頭部分。
E2B(51.1 tok/s)
## ローカルLLM初心者のためのVRAMってなんだろう?(専門用語なしで解説) こんにちは!ローカルでAI(LLM)を動かしたいと思っているんですね。
E4B(28.5 tok/s)
## ローカルLLM初心者にVRAMの重要性を専門用語なしで説明します! ### 💡 VRAMって、何ですか?(超ざっくり言うと) VRAMというのは、**「高性能な計算を一時的に覚えておくための、特別な——
12B(12.3 tok/s)
ローカルLLM(自分のPCで動かすAI)を始めるにあたって、「VRAM」は「AIを動かすための専用の作業机の広さ」だと考えると非常に分かりやすくなります。
26B(23.0 tok/s)
ローカルLLM(自分のパソコンで動かすAI)を始めようとする際、もっとも重要なのが「VRAM(ブイラム)」です。
この程度の課題では4サイズとも十分に読める日本語を書く。速度で選んで問題ない。
【画像生成】SD1.5は15秒、SDXLは3〜4分。落ち方はアプリで2倍違う
LLMで熱ダレを見たので、同じ機体で画像生成も測った。結論を先に書くと、画像生成も落ちる。ただし落ち方が、使うアプリで大きく違った。
計測は2026年9月に、macOS 15.6.1、ComfyUI 0.34.0(PyTorch 2.13.0・MPS)とDraw Thingsで行った。すべて直前に20分アイドルさせ、AC接続・低電力モードオフ・バッチ1で揃えている。なお、ComfyUIは起動時に「Total VRAM 24576 MB」と表示するが、実際にGPUへ回るのは既定の16.0 GiBのままだ。この表示を信じてモデルを選ぶと落ちる。
| アプリ | モデル | 解像度/ステップ | 初速 | 最終 | 低下 | ラン |
|---|---|---|---|---|---|---|
| Draw Things | SD1.5 | 512 / 20 | 15.1秒 | 17.3秒 | +15% | 30 |
| ComfyUI | SD1.5 | 512 / 20 | 18.4秒 | 23.9秒 | +30% | 30 |
| ComfyUI(fp16) | SD1.5 | 512 / 20 | 18.4秒 | 24.8秒 | +35% | 30 |
| Draw Things | SDXL | 1024 / 30 | 158.8秒 | 193.5秒 | +22% | 8 |
| ComfyUI | SDXL | 1024 / 30 | 233.1秒 | 242.9秒 | +4% | 8 |
| ComfyUI | Z-Image Turbo | 1024 / 8 | 211.0秒 | 250.3秒 | +19% | 7 |
モデルはSD1.5がv1-5-pruned-emaonly-fp16(Euler)、SDXLがjuggernautXL_ragnarokBy(Euler)である。初速は2ラン目の値で、ComfyUIは1枚目だけモデルのロードを含むためそうした。低下は2ラン目から最終ランまでの伸びで、SDXLとZ-Imageは8ラン以下なのでブレが残る。
SD1.5は30枚で倍の差が出る
冷えた状態から30枚を連続で生成すると、Draw Thingsは15.05秒から17.27秒(+14.7%)、ComfyUIは18.38秒から23.94秒(+30.3%)になった。初速の差は18%だが、30枚目には28%まで広がる。Draw Thingsは23枚目まで15秒台を保ち、24枚目で16.3秒に上がった。
差が出る理由として、Draw ThingsはPyTorchではなく、作者のLiu Liu氏がPhilip Turner氏と共同開発したMetal FlashAttentionで動いている。電力を測り比べてはいないが、同じ絵を少ない仕事量で出せるぶん熱くなるのも遅い、と考えている。
SDXLは1枚3〜4分
1024×1024・30ステップのSDXLは、1枚目がDraw Thingsで144.8秒、ComfyUIで204.8秒だった。2枚目は158.8秒と233.1秒、8枚目は193.5秒と242.9秒である。ComfyUIは1枚目だけロード(約30秒)を含み、Draw Thingsは毎回プロセスを起動して読み直すため、どちらで比べてもDraw Thingsが30%前後短い。
ただし、ComfyUIの+4%は熱に強いという意味ではない。1ランが4分近くかかるので、2ラン目の時点で既に落ちきっているだけだ。ComfyUIの8ランには3枚目だけ278.6秒と突出した値もあり、SD1.5の30ランほどの確度はない。
Z-Image Turboは期待外れだった
8ステップで速いと聞いて試したのがZ-Image Turbo(6B)だ。FP8版ではなく、ComfyUI公式テンプレートと同じbf16で、UNet 11.46GB・テキストエンコーダ(qwen_3_4b)7.49GB・VAE 0.31GBの合計約19GBになる。16 GiBの枠を超えるが、LLMの26Bのような「エラーも出さずに待たせる」挙動は起きなかった。ComfyUIがテキストエンコーダを退避しながら最後まで処理している。
ただ、速くはならない。2ラン目が210.98秒(1ステップ26.4秒)で、7ラン目には250.31秒まで落ちた。初速で揃えて処理量あたりのスループットを出すと、次のようになる。
| モデル | 総ピクセル×ステップ | 秒 | スループット |
|---|---|---|---|
| SD1.5 512 / 20ステップ | 5.24M | 18.4 | 285k/秒 |
| SDXL 1024 / 30ステップ | 31.46M | 233.1 | 135k/秒 |
| Z-Image 1024 / 8ステップ | 8.39M | 211.0 | 40k/秒 |
Z-ImageはSD1.5の7分の1の効率で、ステップ数を減らしてもモデルが大きければMacでは速くならない。
熱で絞られているのは電力も同じ
ComfyUIのSD1.5を既定のまま回すと、2ラン目は1,469 MHz・14.16 Wで18.49秒だった。11ラン目にはクロックが945 MHz、電力が5.98 Wまで下がり、25.77秒かかっている。ファンレスで捨てられる熱量が上限になり、それに合わせてクロックと電力が絞られた形だ。
ここで測定の落とし穴がある。Thermal pressureは負荷を止めると1分足らずでNominalに戻り、SDXLを40分回した直後でも20秒でModerate、40秒でNominalになった。だが熱が抜けたわけではない。実際、私は冷却の扱いを3回間違えた。バッチ8で測って「ComfyUIは失速しない」と誤認し、温まった機械で測った結果が再現せず(16.1秒から25.1秒だった計測が、やり直すと15.7秒から16.1秒)、さらに比較の片側だけ冷却が4分と871分で食い違っていた。
Apple Siliconのベンチマークは、測る前に何分冷ましたかを記録しないと数字が意味を持たない。本章は20分に統一している。
効く起動オプションは無かった
ComfyUIが勧めてくる--use-split-cross-attentionを含め、各構成を20分アイドルのあと12ランずつ測った。2〜8ラン目の平均は次のとおりである。
| 構成 | 2〜8ラン平均 | 既定比 | 12ラン目 |
|---|---|---|---|
--force-fp16 | 18.55秒 | -1.9% | 21.71秒 |
| 既定(フラグ無し) | 18.90秒 | — | 23.28秒 |
--use-quad-cross-attention | 19.22秒 | +1.7% | 23.86秒 |
--force-channels-last | 20.00秒 | +5.8% | 24.84秒 |
--use-split-cross-attention | 20.18秒 | +6.8% | 22.86秒 |
attention系の変更は全部遅くなり、ComfyUIが勧める--use-split-cross-attentionがいちばん遅い。唯一速く見えた--force-fp16も、3回測って結果が3回とも違った。差は1〜2%でラン間のブレに埋もれる。RadeonではMIOpenや起動オプションで大きく詰められたが、Macでは詰め代が無く、アプリを変える以外に手が無い。
枚数の見積もりと、この章の限界
冷えた状態なら、SD1.5を10枚出すのにDraw Thingsで約2分半、ComfyUIで3分かかる。30枚だと約8分と11分だ。ただし直前に何か回していると7枚目から落ちる。SDXLは10枚でDraw Thingsが30分、ComfyUIが40分で、2枚目には既に落ちているため初速で見積もると足りなくなる。
そこで、枚数を回したいならローカルにこだわらず、ブラウザで完結するConoHa AI Canvas(エントリープラン月500円)のようなクラウドのほうが合理的な場面もある。なお、ANEを使う経路(Core ML・MLX)は未検証で、RX 9070 XTと条件を揃えた比較表も無い。絶対値は日と機体の状態で1〜2割動くので、その幅で読んでほしい。
再現する場合の注意点
/api/ps のメモリ表示は信用してはいけない
Metalでは size がmmapしたファイル全体を返し、実際のGPU割当と一致しない。
| モデル | /api/ps | 実際の割当(サーバログ) |
|---|---|---|
| E2B | 6.52 GB | 1,397 MiB |
| E4B | 8.81 GB | 2,829 MiB |
| 26B | 3.48 GB | 16,147 MiB |
正しい値はサーバログの common_memory_breakdown_print にある。ちなみにこの実割当は、Radeon記事の値(E2B 1.70GB / E4B 3.21GB)とよく一致する。
乖離が出るのは E2B と E4B だけで、12Bと26Bはバッファサイズと実割当が一致する。これは公式モデルカードの記述と符合する。PLE(Per-Layer Embeddings)が入っているのは E2B / E4B のみだからだ。
モデルにレイヤやパラメータを追加するのではなく、PLEは各デコーダレイヤにすべてのトークンに対して独自の小さなエンベディングを与えます。これらのエンベディングテーブルは大きいですが、高速ルックアップにのみ使用されるため、有効パラメータ数は合計よりずっと小さくなります。 — Gemma 4 モデルカード(拙訳)
「ダウンロードは大きいがメモリは小さい」というPLEの性質は、Macでも同じように効いている。
プロンプト処理速度は2回目以降が当てにならない
Ollamaはプロンプトキャッシュが既定で有効で、同じプロンプトの2回目以降は処理をスキップする。これは公式ドキュメントには記載がなく、サーバログから確認した挙動である。
srv load_model: prompt cache is enabled, size limit: 8192 MiB
slot operator(): task 0 | cached n_tokens = 0     ← 1回目
slot operator(): task 0 | cached n_tokens = 26    ← 2回目以降
連続計測するとE2Bで363 tok/sという嘘の値が出る。本記事のプロンプト処理速度は、すべて冷却後の1発目のみを採用した。
think を切る必要がある
Gemma 4は思考モードが既定で有効で、切らないと生成した分が消える。本記事の計測はすべて "think": false で行っている。
この計測の限界
- Ollamaのバージョンが異なる。 Radeon側は0.32.5、Mac側は0.33.0
- 基底負荷がある。 WindowServerと作業用アプリが常時CPU 20〜30%を使う状態で計測しており、デスクトップ環境より不利な条件
- コンテキスト長4,096での計測。 長文脈では26Bがさらに不利になるはず
- 量子化はQ4_K_M固定
- ダイ温度は測れていない。
powermetricsのsmcサンプラはIntel専用で、Apple Siliconには存在しない。温度はバッテリー温度(ioreg)による代理指標 - 31Bは1回の観測で「実用外」と判定した。 3回計測の中央値は取っていない
- 既存記事自身が「絶対値は日やマシンの状態で1〜2割変動する」と断っている。本記事の比較も同程度の幅を持って読んでほしい
まとめ
- 24GBのMacでも、GPUが使えるのは既定で16.0 GiB。 RX 9070 XT(15.9 GiB)とほぼ同じ
- 26Bは68 MiB足りずに失敗する。 しかもHTTP 200を返して0トークン、4分待たされる
sudo sysctl iogpu.wired_limit_mb=20480で解決する。 26Bは23.0 tok/sで動く- 26Bは12Bの1.8倍速い。 MoEで毎トークン3.8Bしか読まないため
- 31Bは無理。 スワップ94%で機械そのものが止まる
- ファンレスは4分で3割落ちる。 12.4 → 9.0 tok/s、GPUクロックは1,469 → 763 MHz
- 短く聞くなら12.4、書かせ続けるなら9.0 で見積もるとよい
RX 9070 XTでの計測は以下の記事にまとめてある。
お断り
本記事の速度・メモリ使用量はすべて筆者環境での実測値であり、Apple・Google・Ollamaのいずれによる公式値でもない。
本文中の以下は一次情報が存在せず、筆者の実測・観測に基づく
- 24GB機のGPU枠が16.0 GiBであること ── Ollamaサーバログの
inference compute行で確認。
Appleはこの配分を公式に文書化していない
iogpu.wired_limit_mbの挙動 ── Appleの公式ドキュメントに記載がないsysctl。
本記事では実際に設定してOllamaの認識が16.0→20.0 GiBに変わることを確認した
- Ollamaのプロンプトキャッシュ ── 公式FAQに記載なし。サーバログから挙動を確認
- 各モデルの実メモリ割当 ── サーバログの
common_memory_breakdown_printより - Thermal pressure とGPU周波数 ──
powermetrics --samplers cpu_power,gpu_power,thermalより。
なお smc サンプラはIntel Mac専用で、Apple Siliconではダイ温度を取得できない
参考文献



コメント